摘要#
光学神经网络利用光场调制、传播与探测实现神经网络中的信息变换,其计算性能由光学器件、输入编码、读出和电子控制共同决定。本文分析光场编码、线性传播、非线性激活与训练机制,比较衍射网络、干涉网络、傅里叶光学、波分复用系统和光学动力学网络的计算路径。代表性研究展示了图像分类、光通信处理及多模态感知等任务中的器件实现。文献分析显示,架构能力与器件损耗、噪声、参数调节、光电转换和系统边界密切相关;端到端延迟与能效评价需要统一任务、精度和统计口径。光学器件与电子电路的分工、物理训练和多自由度复用构成后续研究的主要方向。
关键词:光学神经网络;光计算;衍射神经网络;集成光子学;光电混合计算
Optical Neural Networks: Fundamentals, Architectures, and Applications
Abstract: Optical neural networks use modulation, propagation and detection of optical fields to implement information transformations in neural computation. Their performance depends on optical devices, input encoding, readout and electronic control. This review examines field encoding, linear propagation, nonlinear activation and training, and compares diffractive networks, interferometric circuits, Fourier optics, wavelength-division multiplexing and optical dynamical networks. Representative studies demonstrate applications in image classification, optical communications and multimodal sensing. Device loss, noise, parameter control, optical–electrical conversion and measurement boundaries shape practical performance. Meaningful assessment of end-to-end latency and energy efficiency requires consistent tasks, accuracy requirements and accounting boundaries. Optical–electronic integration, physical training and multiplexing across degrees of freedom are directions for further study.
Keywords: optical neural networks; optical computing; diffractive neural networks; integrated photonics; optoelectronic computing
引言#
神经网络将输入数据映射为预测结果,计算过程通常包含矩阵乘法、卷积、非线性变换和多层特征传递。模型运行所需的时间与能量由算术运算、数据传输、存储访问和控制电路共同决定。训练还要计算梯度并更新参数,推理则在既定参数下处理新输入(Shastri et al. 2021; Zhou et al. 2022)。
光学系统能够利用传播、衍射和干涉变换光场。在线性工作条件下,输出复光场可表示为输入通道复光场的线性组合;输入之间的相干性与探测条件共同决定输出信号中干涉项的贡献。合适的器件参数可以使光场变换对应矩阵运算。光场也可用波长、空间位置、时间和偏振承载不同信号,为并行处理提供多个物理自由度。器件损耗、输入调制、信号读出与控制电路共同决定完整系统的性能(Fu et al. 2024; Bai et al. 2023)。
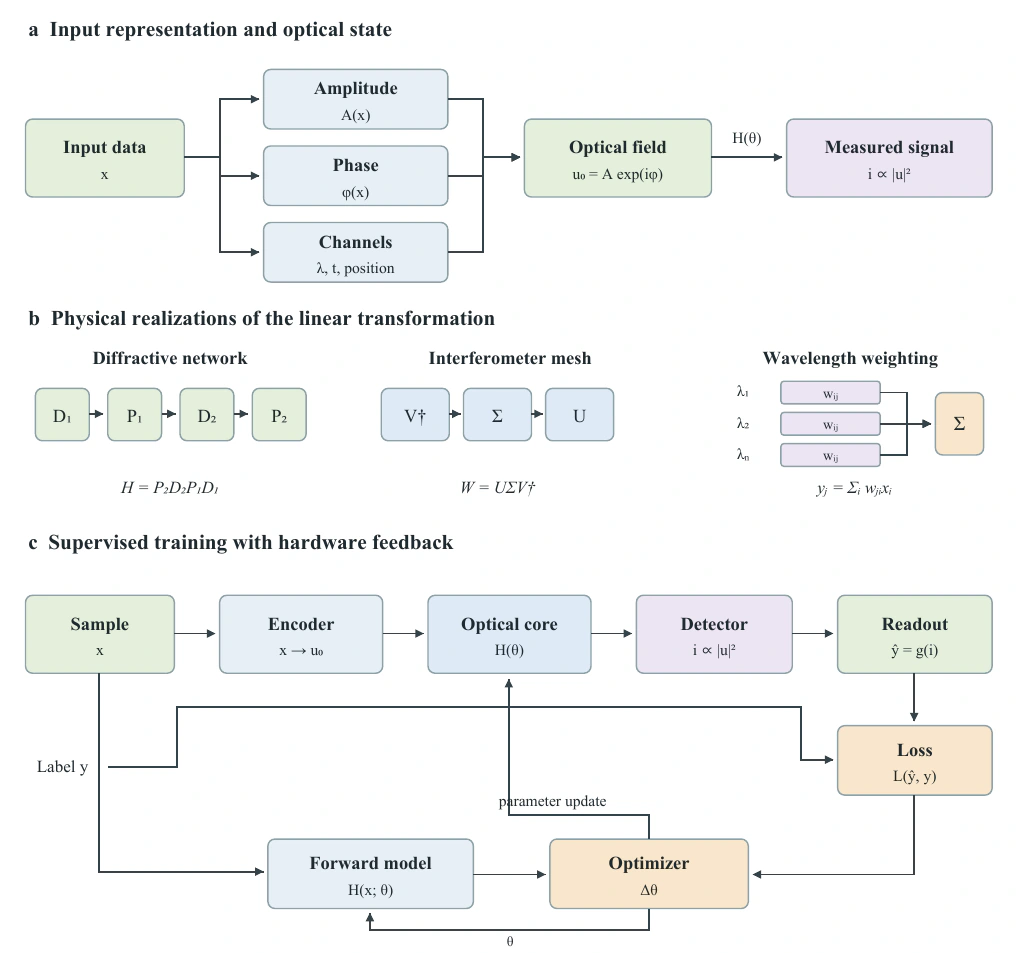
光学神经网络的信号、器件与训练框架。(a)输入编码、光学变换与探测;(b)衍射、干涉和波分复用的代表性计算形式,波分加权表达式中的 表示功率编码或相应电信号,通道功率求和依赖探测带宽和拍频条件;(c)结合数值模型与实验反馈的参数优化示意。 表示器件控制参数, 表示任务损失。各类系统的具体器件和信号接口依实际实现确定。
本文将光学神经网络(optical neural network,ONN)界定为利用光学器件完成神经网络中部分或全部信息变换的计算系统。这个定义覆盖自由空间衍射器件、集成光子干涉网络和光电混合网络,也包括借助光学动力学处理时间序列的系统。各系统的光学部分可能承担线性映射、特征提取或具有记忆的动态变换;参数训练、非线性和输出判读可以由不同的光学或电子模块执行(Fu et al. 2024; Zhang et al. 2025)。
不同论文对计算性能的统计口径存在差别。光学传播时间、设备持续吞吐和输入到输出的端到端延迟描述了不同环节;运算次数与能耗也受乘加计数方式、光源以及控制电路边界影响。准确评价这些性能需要明确光场与探测光强、器件与架构、训练与推理之间的对应关系。
把神经网络映射到物理装置时,首先需要确定模型中哪些运算适合由传播过程执行。矩阵乘法可以通过多模式之间的耦合形成,卷积可以利用频域滤波或时延与加权完成,动态网络则可以利用器件的状态演化处理序列。每条路线都需要定义输入数据如何转换为光信号、可调参数如何对应权重以及结果如何读出。相同的神经网络结构在不同物理平台上可以采用不同的数据通道和控制方法(Zhou et al. 2022; Zhang et al. 2025)。
光学计算的并行性也有多种来源。自由空间传播使输入平面上的多个位置共同影响输出场;集成波导利用多个模式之间的耦合形成线性网络;波分复用在一个系统中组织多个频谱通道;时间复用让同一设备按顺序处理多个计算阶段。这些方式对器件面积、输入加载、光源功率及数据缓存提出各自要求(Bai et al. 2023; Zhang et al. 2026)。
本文以代表性原始研究和综述为基础,讨论自由空间衍射、集成干涉、波长复用、光电非线性与物理训练,并结合储备池研究分析时间信息处理。文章围绕光场变量、器件结构与神经网络算子的对应关系,进一步讨论系统数据路径、典型任务与性能评价。
光学神经网络的基本原理#
人工神经元与矩阵运算#
一个人工神经元接收输入 ,将它们与权重 相乘并求和,再加入偏置 ,最后经过激活函数 :
权重决定各输入对输出的影响,偏置调整响应位置,激活函数改变输入与输出之间的函数关系。多个神经元组成一层时,权重可整理为矩阵 ,输入和偏置分别整理为向量 、,得到
其中激活函数通常逐元素作用。以修正线性单元为例, 将负输入截断为零。单层的矩阵乘法为光学实现提供了映射对象:输入数据、权重和输出结果分别对应可控制或可测量的物理量(Zhou et al. 2022)。
卷积也可表示为加权求和。以一维离散卷积为例, 中,卷积核 在不同位置重复使用。若将输入展开,并把卷积核按平移关系排列,卷积能够写为具有特定结构的矩阵乘法。构造这一矩阵会影响所需的数据复制和存储,物理系统的效率取决于实际的数据排布与输入输出方式。
矩阵的结构决定硬件需要提供多少独立控制量。一个一般的实数矩阵包含相互独立的实系数;卷积矩阵的许多元素由同一卷积核重复生成,循环矩阵还要求边界按周期连接。光学傅里叶结构能够利用这些约束减少独立可调单元,代价是可直接表示的矩阵集合受到限制。适用于循环卷积的线性规模实现利用了其参数共享关系,一般稠密权重矩阵的硬件需求则需另行分析(Zhu et al. 2022; Zhou et al. 2022)。
偏置的实现也依赖信号表示。在相干光学系统中,可引入参考通道,把固定复振幅与加权输出叠加。若输入和输出采用非负功率编码,也可在电子读出端加入偏置。后一种设计的偏置作用于探测后的实变量,其数学位置与探测之前加入参考场不同。将偏置、归一化和激活的顺序明确写入模型,有助于区分不同计算流程所表达的函数。
光场编码与探测#
在单色标量近似下,一个平面上的复光场可写为
这里 为振幅, 为相位, 为光强。输入图像可以映射到空间位置,并用透射率改变振幅;相位调制则通过改变局部光程表达数据。空间光调制器(spatial light modulator,SLM)是实现这种调制的一类器件。波长、偏振、时间和波导模式也能承载信息;所选编码方式影响可用的信号范围、器件规模和测量方法(McNeil et al. 2024; Bai et al. 2023)。
相位与光强具有不同的可观测性。单个理想探测器直接给出入射光功率相关的响应,复场相位的恢复需要更多测量约束。通过参考光干涉、相干接收或多次测量可以获取相位信息,这些过程增加了光路或读出要求。当数据编码在强度中时,光学器件对振幅的作用与最终强度变化之间包含平方关系;描述计算时需要指明变量属于复场还是实数强度。
输入、权重和输出可以使用不同编码。相位参数具有周期性,两个相差 的理想相位代表相同光学状态;实数负权重则常借助相位差、差分通道或平衡探测表示。若使用两路非负信号之差来表示有符号数,输出噪声与两路光功率均有关,所需探测器和光功率也应计入系统代价。
以灰度值 为例,振幅编码 会产生与 成正比的输入光强;强度编码 对应的振幅则正比于 。两种方式给光学网络的输入复向量不同,训练时应使用与实验调制一致的表达。相位编码可写为 ,若选择线性相位映射 ,输入数据到复光场的映射已经包含指数函数。对于同一个线性传播系统,改变编码方式会改变输出对原始数据的函数形式,这也是评估网络表达能力时必须说明编码的原因(Zhang et al. 2025; Yildirim et al. 2024)。
空间并行与时间串行对应不同的数据组织。把一幅图像一次加载到二维调制面,能够使许多位置的光场共同传播;把一个向量依次编码到时间脉冲,则需要通过延迟、积分或缓存建立不同元素之间的对应关系。波长复用可让多路信号共用传播路径,接收端需要按任务选择分波检测或功率汇聚。偏振编码则要求器件具有适当的偏振响应,并在输入与输出处定义分析基底。这些自由度可以组合使用,实际独立通道数还受到串扰、光谱带宽和探测能力约束(Bai et al. 2023; Li et al. 2022)。
探测器在有限面积和时间内积累信号。对于第 个分类区域,其读出量通常接近
其中 为检测区域, 为积分时间, 表示响应系数;宽带检测时还需对波长积分。选择最大 作为类别,将连续光分布转化为离散决策。输出平面出现清晰光斑与获得较高分类准确率分别涉及能量分布和标签统计,两者需要各自的评价量。若检测区域之外仍有大量光能,正确分类也可能伴随较低的有效光能利用率(Lin et al. 2018)。
干涉、衍射与线性映射#
在固定介质参数和线性响应条件下,光场遵循叠加原理。设若干光场同时到达探测位置,则
展开光强表达式可得到各分量的强度项与交叉干涉项。交叉项依赖相对相位,所以调整光程可以改变具有稳定相位关系的信号在输出端的功率分配。当信号间相位关系在探测积分时间内变化,平均后的交叉项由互相干程度决定;互相干项趋于零时,强度传播模型可以分别汇聚各输入通道的贡献(Rahman et al. 2023)。
将输入与输出的空间位置或波导模式离散化后,固定线性光学系统可记作
矩阵 的元素描述输入通道到输出通道的复振幅传输系数。自由空间系统中的 由调制层与传播距离共同决定;集成干涉网络则利用可调耦合器和相移器组合形成矩阵。无损且封闭的理想模式网络可由酉矩阵描述,真实系统中的吸收、散射和未收集模式使传输一般呈现损耗(Clements et al. 2016; Zhou et al. 2022)。
波经过孔径或相位结构后,输出平面的各位置接收来自输入平面不同位置的贡献。衍射的计算作用由调制与传播共同形成,单个像素的局部调制直接改变该像素处的光场。透镜在一定近轴条件下可以把输入平面的空间频率映射到焦平面,使频域滤波能够通过空间位置选择实现。该近似依赖波长、孔径和系统几何条件,有限孔径还会限制可传输的空间频率(McNeil et al. 2024; Hu et al. 2024)。
在标量、单色、近轴传播条件下,平面间的耦合可以用菲涅耳积分表示:
其中 , 为传播距离, 和 分别为输入与输出平面的坐标。积分核给每个输入位置赋予与位置和距离有关的复系数。把输入平面划分为像素后,积分转化为离散求和,便建立了衍射与矩阵乘法的联系。较大的传播角、亚波长结构或强偏振耦合需要角谱法、矢量模型或电磁仿真检验。数值离散还要结合采样间隔和计算窗口评估混叠(McNeil et al. 2024; Lin et al. 2018)。
相干性决定可以保留哪些求和项。若输入通道的互相干项在探测时间内平均为零,则输出的时间平均强度满足 。此时强度传输矩阵的元素非负,其结构由复场传输矩阵的模平方决定。相干系统则保留不同输入之间的交叉项,输出强度因而包含不同输入场之间的相位相关项。Rahman等(Rahman et al. 2023)针对空间非相干照明设计衍射处理器时,明确以非负强度矩阵为目标,并在数值模型中处理随机相位平均。这一结论也提示,相干条件变化会改变计算模型,变化后的系统需要重新确定相干项和传播表达式。
无损线性变换守恒总功率,对应合适归一化下的酉关系 。一般神经网络权重可改变向量的长度,因此实现一般矩阵通常需要进一步引入衰减、额外端口或增益。通过奇异值分解 ,两组酉变换与对角幅度调节可分工完成目标运算;当采用被动衰减时,可先把最大奇异值归一化到可实现范围,再在结果解释或读出中补偿比例(Clements et al. 2016; Shen et al. 2017)。归一化后的系统仍受光子预算约束:过强的衰减仍会降低小输出分量的可辨识性。
探测、非线性与多层计算#
多层数字神经网络通过线性变换与非线性激活交替形成复杂函数。若各层仅由固定线性算子组成,其整体复场映射仍可写为算子的乘积 。经典被动相位型衍射网络中的层间传播通常遵循这一线性模型,输出探测器再给出平方律光强。因此,最终探测引入的非线性与能够在层间重复级联的激活需要分别描述(Lin et al. 2018; Destras et al. 2023)。
一种层间激活方法是将光信号探测为电信号,在电子电路中执行非线性变换,再用调制器生成下一层输入光场。该方案可以利用成熟的电子电路,但层间转换引入探测、放大、调制及同步开销。另一类方法使用非线性材料或有源光子器件,其输入输出关系随光功率改变;器件能否用于网络级联还取决于工作功率、响应速度、损耗和输出信号质量(Destras et al. 2023; Chen et al. 2024)。
非线性也可能来自特定的数据编码与结构组合。Yildirim等(Yildirim et al. 2024)研究的方案将输入写入可重复作用于传播光的空间调制结构,光经过多次与同一输入相关的调制后,输出对编码变量呈现高阶依赖。对固定调制结构而言,光场传播仍服从线性叠加;讨论该工作时,应将输入变量的非线性映射与材料响应区分。
线性传播与训练参数之间也有区别。固定器件的输出对入射复场是线性的,但输出对相位参数通常含有指数项及多个层的乘积,损失函数因而可以是非凸的。梯度下降优化的是器件参数,训练完成后的材料响应仍由器件的物理性质决定。对于被动多层衍射结构,增加层数可扩展可调参数和可实现算子的集合,改善有限孔径下的能量分配;它与每层都具有独立激活的数字深层网络对应不同的函数构造方式(Lin et al. 2018; Hu et al. 2024)。
平方律探测后再编码可形成实际的层间非线性。若第 层输出先经探测,再作为下一次调制的输入,计算图中便出现 ,其中 包括读出处理与重新编码。器件复用可以让同一个传播模块依次承担多个层,而系统的总延迟包含每次读出和加载。Zhou等(Zhou et al. 2021)的可重构衍射处理单元利用这一组织方式配置前馈网络及循环网络。
非线性器件的工作机制与级联条件#
激活函数把线性变换得到的中间量映射到下一层使用的信号。数字模型通常以单个变量的函数定义激活,而光子器件的输入和输出涉及功率、复振幅、相位、波长和时间。建立两者之间的关系,需要先定义一个神经元的输入变量及其测量位置,再确定器件的输出由哪个物理量表示。器件的静态响应曲线和动态响应共同决定其可用于哪些网络形式(Destras et al. 2023; Shastri et al. 2021)。
光电激活的一种路径由探测器、电子电路和光调制器组成。光电探测把输入光功率转换为电流,电路将电流转换、放大或整形,调制器再使用这一电信号改变新的光载波。探测器和调制器的工作范围决定可表达的输入输出区间;电路中的阈值、增益和偏置可用于调整激活曲线。某些集成系统将探测与调制放在相邻器件中,通过局部模拟电路完成信号转换(Ashtiani et al. 2022; Bandyopadhyay et al. 2024)。
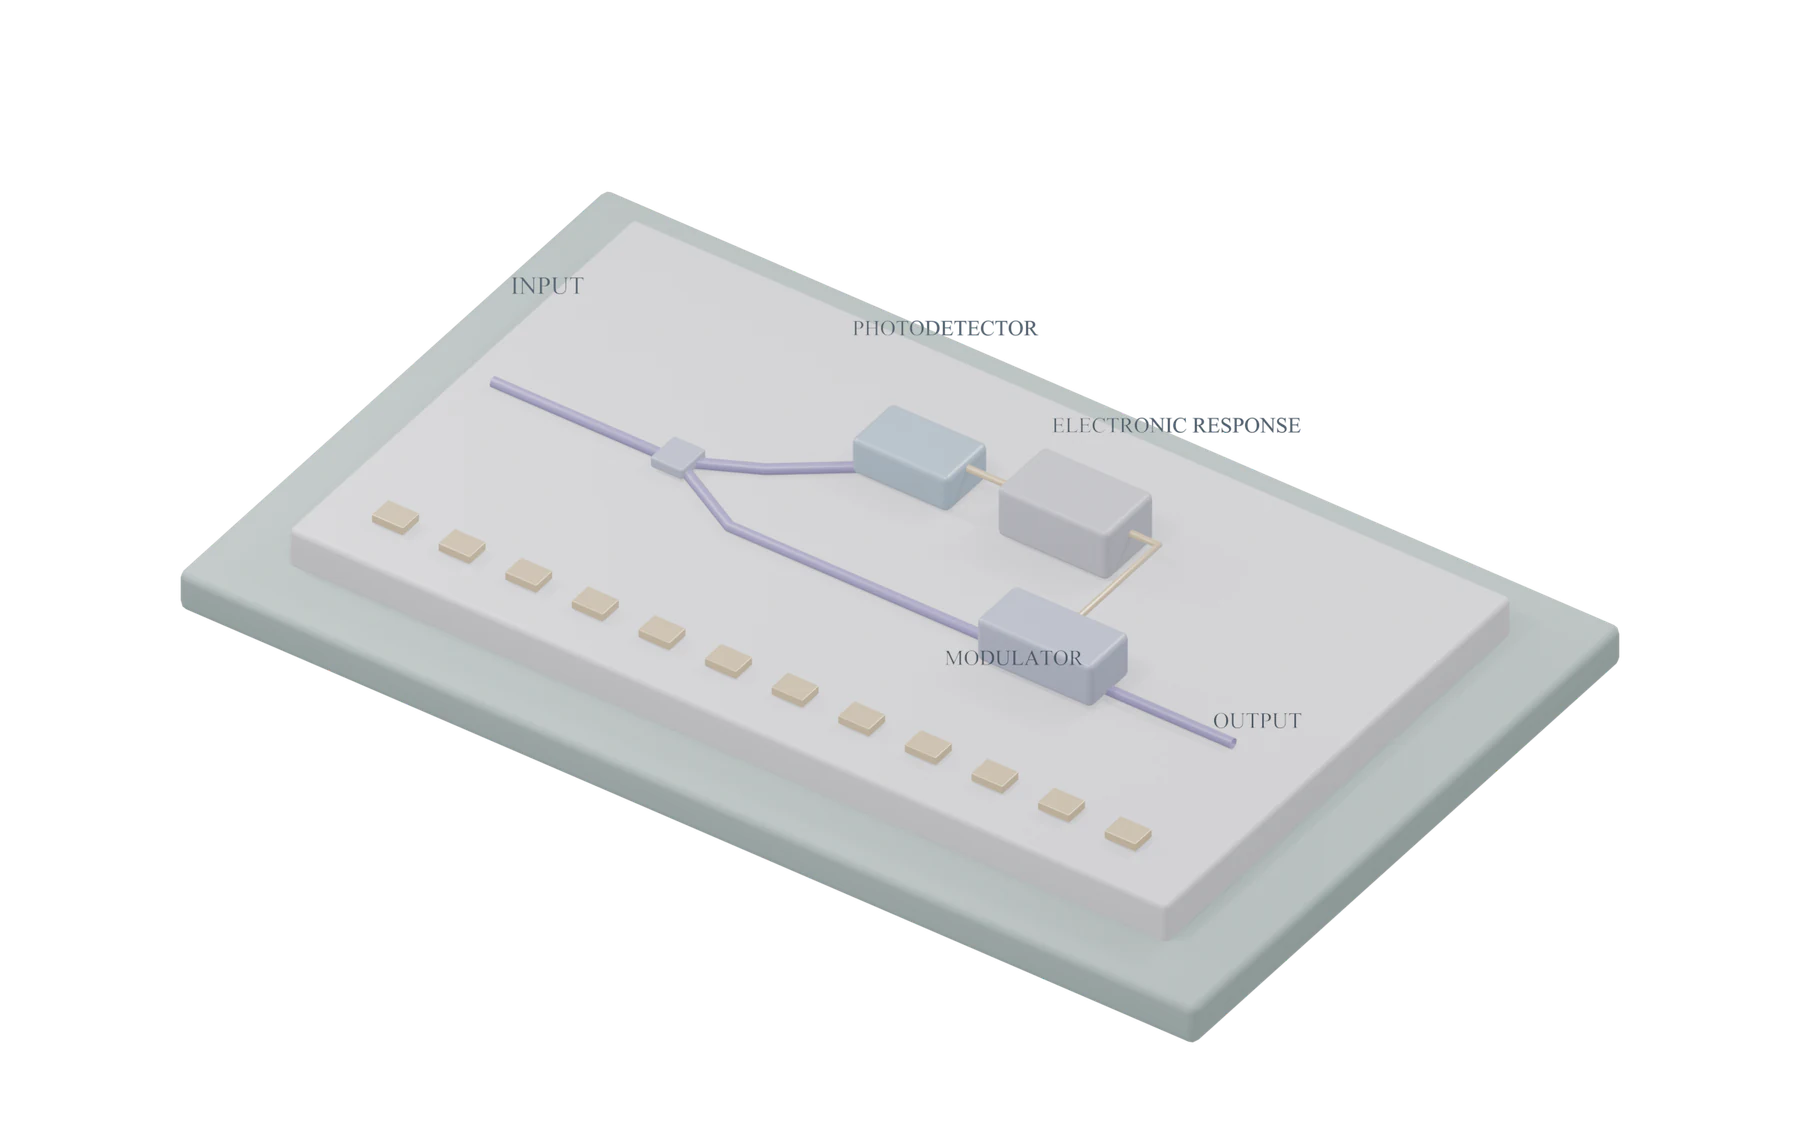
光电激活单元的结构示意。输入光经分支送至探测器,电子响应驱动调制器,光信号经调制后传向后续模块;具体供光、偏置与器件参数由系统设计确定。
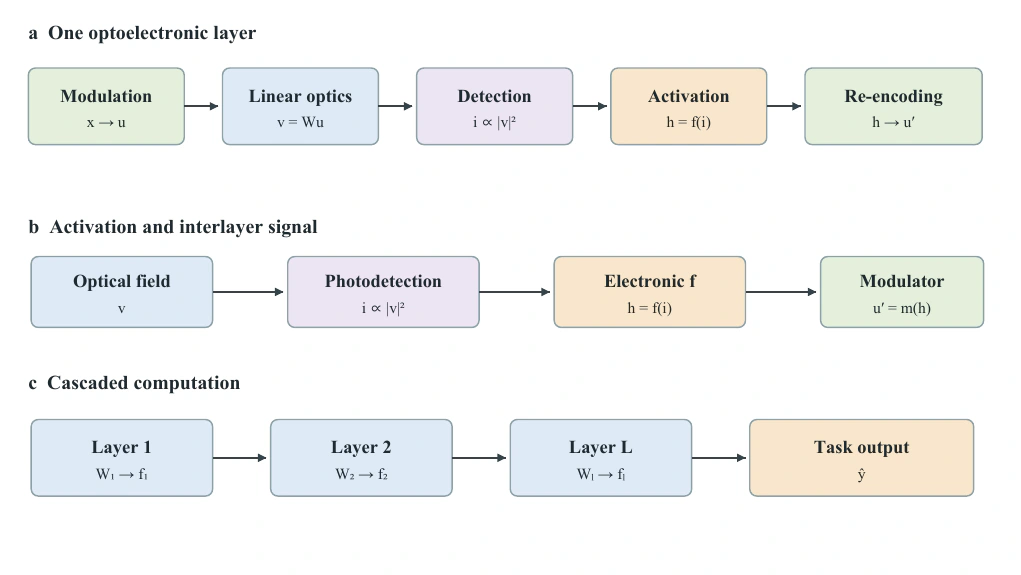
光电多层网络的数据流程。单层计算依次包含编码、光学变换、探测与激活;多层系统通过中间信号连接各逻辑层,并由输出模块完成任务读出。
光电激活的链路还需要提供光源和电源。第 层探测到的功率经过电路调制新的载波,下一层得到的光功率受调制器传输函数和载波功率影响。若输出需要分配给多个节点,分光器件进一步分配功率。可以通过测量输入功率、调制器偏置、输出光功率以及驱动电流,得到单个激活单元在给定频率下的工作点,并将该工作点输入网络训练模型。
饱和吸收提供另一种输入相关响应。随着入射光强变化,材料的吸收系数改变,器件透射率随之变化。一个用于理解趋势的简化形式为
其中 是输入光强, 为表征饱和的强度尺度, 和 分别代表模型中的可饱和和背景损耗参数;在该透射率模型中,两项取非负值,且其和至多为1。该式用于说明一类理想化响应;具体器件的曲线需要由材料、脉冲条件、波导结构及实验测量确定(Destras et al. 2023; Chen et al. 2024)。
激活器件的时间响应需要与输入信号匹配。对连续光输入,稳态透射曲线可以描述某些平均行为;对短脉冲,载流子、热量或材料状态的恢复过程会影响相邻脉冲。输入间隔与恢复时间的比值决定输出是否保留先前输入的影响。若任务希望逐样本独立处理,可测量不同脉冲间隔下的响应;若任务需要时间记忆,则可把这一动态效应纳入状态模型。
相位非线性与振幅读出之间可以通过干涉或滤波建立联系。若材料折射率随光强变化,传播后获得的相位随输入功率改变;再经过干涉结构,输出端的光功率会随相位变化。此时输入到最终探测功率的函数由材料、传播长度、干涉偏置和损耗共同决定。设计时应给出器件的功率范围、相位变化量以及输出曲线的测量方法,模型中的激活函数可采用实测响应或经验证的近似。
层间级联还包括信号格式的匹配。上一层输出的波长、功率和时间波形需要适合下一层输入;多层网络通常还要求各节点具有合适的增益、扇出和噪声余量。固定器件的非线性曲线提供一种物理约束,网络训练可以在该曲线上调整线性权重、偏置和归一化;若器件具有可调偏置,还可把偏置加入参数集合(Destras et al. 2023)。
比较激活方案时,可以选用相同任务、输入速率和精度目标,分别记录静态功率、每次输入的能量、响应带宽、器件面积和层间插入损耗。光学传播时间描述信号通过器件的一个时间尺度,材料恢复、探测积分和控制电路则对应其他时间尺度。完整的测试可以记录这些量之间的关系,并观察多层连接后的任务误差。
训练、推理与物理控制#
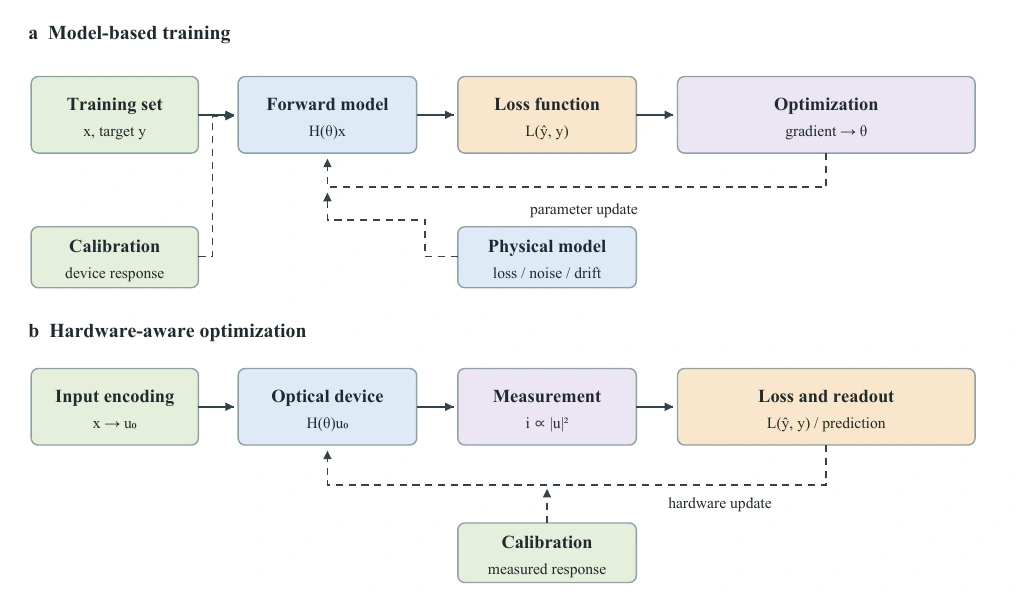
离线训练与物理训练的数据流程。离线训练由传播模型与数值优化产生器件参数;物理训练利用硬件测量更新控制参数。两种流程均可形成用于推理的器件配置。
训练过程根据任务损失调整网络参数,推理过程则使用给定参数处理新输入。离线训练先建立数值传播模型,在计算机中优化权重,再将参数转换为器件的相位、透射率或驱动量。经典衍射深度神经网络(diffractive deep neural network,DNN)采用这一思路,通过数值优化设计衍射层,并以制造出的结构完成光学实验(Lin et al. 2018)。
数值模型与硬件之间常存在由制造偏差、探测误差、热漂移和器件耦合造成的差异。原位训练让真实硬件参与输出测量或梯度获取,通过实验反馈修正参数。根据系统设计,损失计算、参数更新和控制可由电子设备完成。物理反向传播、前向扰动测量和其他梯度估计方法在测量次数、器件结构与对模型的依赖方面存在差异(Pai et al. 2023; Xue et al. 2024; Bandyopadhyay et al. 2024)。
训练的直接优化对象可写为器件参数向量 ,其包含相位、透射率或电压等变量。对训练集中的输入 和目标 ,常见形式为
其中 表示器件的可实现范围, 为任务损失, 为附加约束, 控制其权重。相位调制范围、离散制造高度、功率限制和串扰模型均可通过这一框架进入优化。若训练只追求类别正确,低光效率解仍可能具有较小损失;增加输出能量或分类信号对比度约束,有助于把任务目标与检测条件联系起来(Luo et al. 2019; Duan et al. 2023)。
从优化相位到硬件电压通常需要标定。热光相移受加热功率和温度影响,驱动电压与相位的对应关系需要通过测量确定,相邻器件还会通过热扩散相互作用。固定厚度结构则需要把相位映射为材料折射率与几何长度,并检查工艺可达到的最小特征。Fu等(Fu et al. 2023)在片上衍射网络中使用填充二氧化硅的硅槽组表示预训练相位,并对实际器件误差实施输入相位和输出功率补偿。
参数更新速度和数据处理速度对应两类时间尺度。固定权重推理可以让连续输入使用同一器件状态;热光调节则需要等待温度变化和稳定。当任务权重长期保持时,缓慢更新仍可适应持续推理。若一个大模型需要把多个子矩阵依次写入同一光学核,重配置时间便进入每次推理的数据路径(Zhou et al. 2021; Cheng et al. 2024)。
从数字输入到探测读数的示例#
一个具体的两输入问题有助于理解编码方式。假设数字输入为 ,相干调制器将其映射为两个复振幅 ,理想光学网络提供复矩阵 。若某个输出端的系数为 和 ,则该端复场为 ,直接探测的光功率与 成比例。光学线性变换、输入编码与平方律读出构成连续的计算路径(Zhou et al. 2022)。
对这个输出取平方后,出现 、 以及与两路相对相位相关的交叉项。若目标变量是加权和 ,可以通过与参考光混合并使用相干接收来获取所需的场分量;若任务模型直接使用光强,训练时可以把完整的平方表达式作为输出函数。两种读出分别定义了光学网络与电子处理模块之间的接口。
再考虑强度编码。若两个输入映射为两束互不相干光的功率 和 ,某输出探测器在适当的平均条件下给出与 成比例的信号,、 表示对应路径的功率传输系数。可调滤波器能够控制这些系数;若需要有符号结果,可以使用两组输出的差值。该例子中的求和发生在光电读出环节,计算模型依赖光源相干条件、探测带宽与滤波器响应(Rahman et al. 2023; Tait et al. 2017)。
相干光与非相干光之间还存在部分相干状态。用互相干矩阵 表示输入统计量,经过固定线性系统后,输出互相干矩阵为
第 个探测通道的平均强度对应 的第 个对角元素。输入通道间的相关程度决定 中交叉项的大小;将实际照明条件写入 ,可以把相干与非相干模型放在统一的统计框架下理解。
一个差分读出的实例可以说明符号和噪声。假设两只探测器接收的信号为 和 ,电子输出为 ,其均值对应两路信号之差。若两路噪声独立,输出方差为两路方差之和;若噪声具有相关性,方差还包含协方差项。电路设计可以利用相同光源带来的共同变化,也需要测量通道增益与响应速度。模型训练时,可用测量得到的噪声参数模拟不同输入下的读出分布。
物理层、逻辑层与数据复用#
物理层指装置中固定位置或固定模块的器件结构,逻辑层指神经网络计算图中的一次参数化变换。多个逻辑层可以使用多组独立光学结构,也可以通过时间调度反复使用同一器件。后者需要在相邻调用之间保存或转换中间信号,并将该次逻辑层的参数写入调制器。模型图中的层数和硬件照片中的调制面数因此提供互补的信息(Zhou et al. 2021; Bandyopadhyay et al. 2024)。
以两层前馈网络为例,第一层把输入 映射为中间状态 ,第二层再把 映射为输出 。若两个光学模块依次连接,中间状态可以通过光电激活模块传给下一层;若两个逻辑层复用同一模块,系统需要在完成第一层读出后加载第二组参数和中间数据。光传播时间、信号转换时间、参数设置时间及控制调度共同形成每个样本的运行时间。
权重保持方式与复用策略密切相关。固定衍射结构可在制造后持续执行同一变换,热光或电光调制器可通过控制信号更新参数,相变材料可以保持写入的光学状态。选择哪种器件取决于模型切换频率、所需精度、更新能量和目标吞吐。模型长期稳定运行时,初始化与校准开销可按大量样本分摊;任务频繁变化时,更新过程进入更直接的性能预算(Feldmann et al. 2021; Fu et al. 2023)。
主要技术架构与分类#
分类维度与器件关系#
光学神经网络可以按实现平台、计算机制、网络形式、非线性来源和参数调节能力分类。自由空间系统使用光束在空气中传播;集成光子系统利用波导和片上器件约束光场;光纤系统与光电混合系统则采用不同形式的传播或电路组合。平台说明器件如何组织,具体运算还需要结合光场传播和编码方式描述(Fu et al. 2024; Zhang et al. 2025)。
衍射、干涉与波分复用分别对应波前传播、相干叠加和多波长信号组织,可以在同一系统中组合。网络形式进一步决定这些物理过程如何构成计算:前馈结构依次传递特征,循环结构还将先前状态带入后续计算。因而,同类器件可服务于不同网络,同一网络也可由不同传播和调制机制实现。
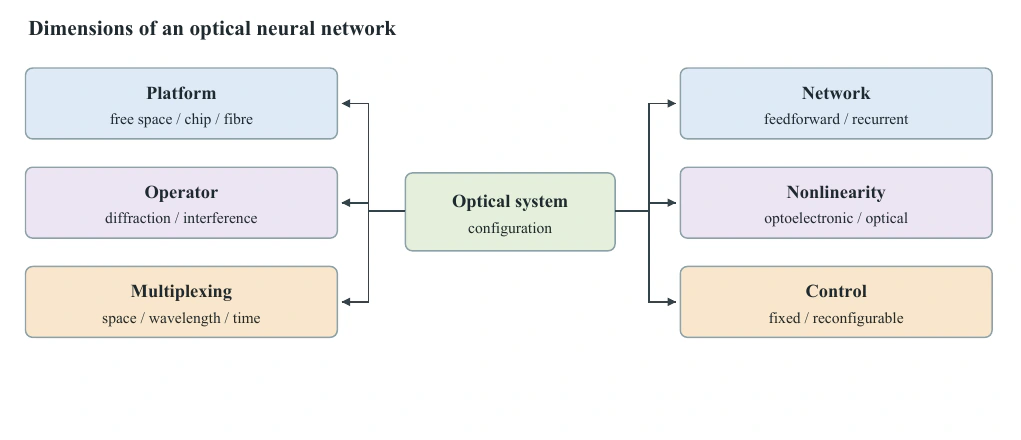
光学神经网络的多维分类。平台、算子、复用方式、网络形式、非线性和参数控制分别描述系统的不同侧面;具体架构可由这些维度共同表征。
| 分类维度 | 可选类型 | 表达的信息 |
|---|---|---|
| 实现平台 | 自由空间、片上波导、光纤 | 光场传播与器件集成方式 |
| 计算机制 | 衍射、干涉、傅里叶变换、动力学 | 物理变换与状态演化 |
| 复用方式 | 波长、空间、时间、偏振 | 信号的并行组织方式 |
| 网络形式 | 前馈、循环、储备池、脉冲 | 模型的信息流与时间结构 |
| 参数控制 | 固定、可重构、原位训练 | 参数设置与更新方式 |
光学神经网络的分类维度与实例
衍射光学神经网络#
衍射网络使用空间调制层控制光波。入射光的不同位置经过振幅或相位调制后,在传播中相互耦合,输出平面的光场由整个上游波前共同决定。若以 表示第 层入射复光场,以 表示该层的复透射函数,标量线性模型可以写成
其中 为振幅透射系数, 为相位调制, 为传播距离 对应的传播算子。数值设计根据任务定义损失函数,通过传播模型优化各层参数;实体器件则按优化参数制造或配置。这个方程忽略了某些器件的矢量效应和非线性响应,适用范围由建模条件决定(Hu et al. 2024; Lin et al. 2018)。
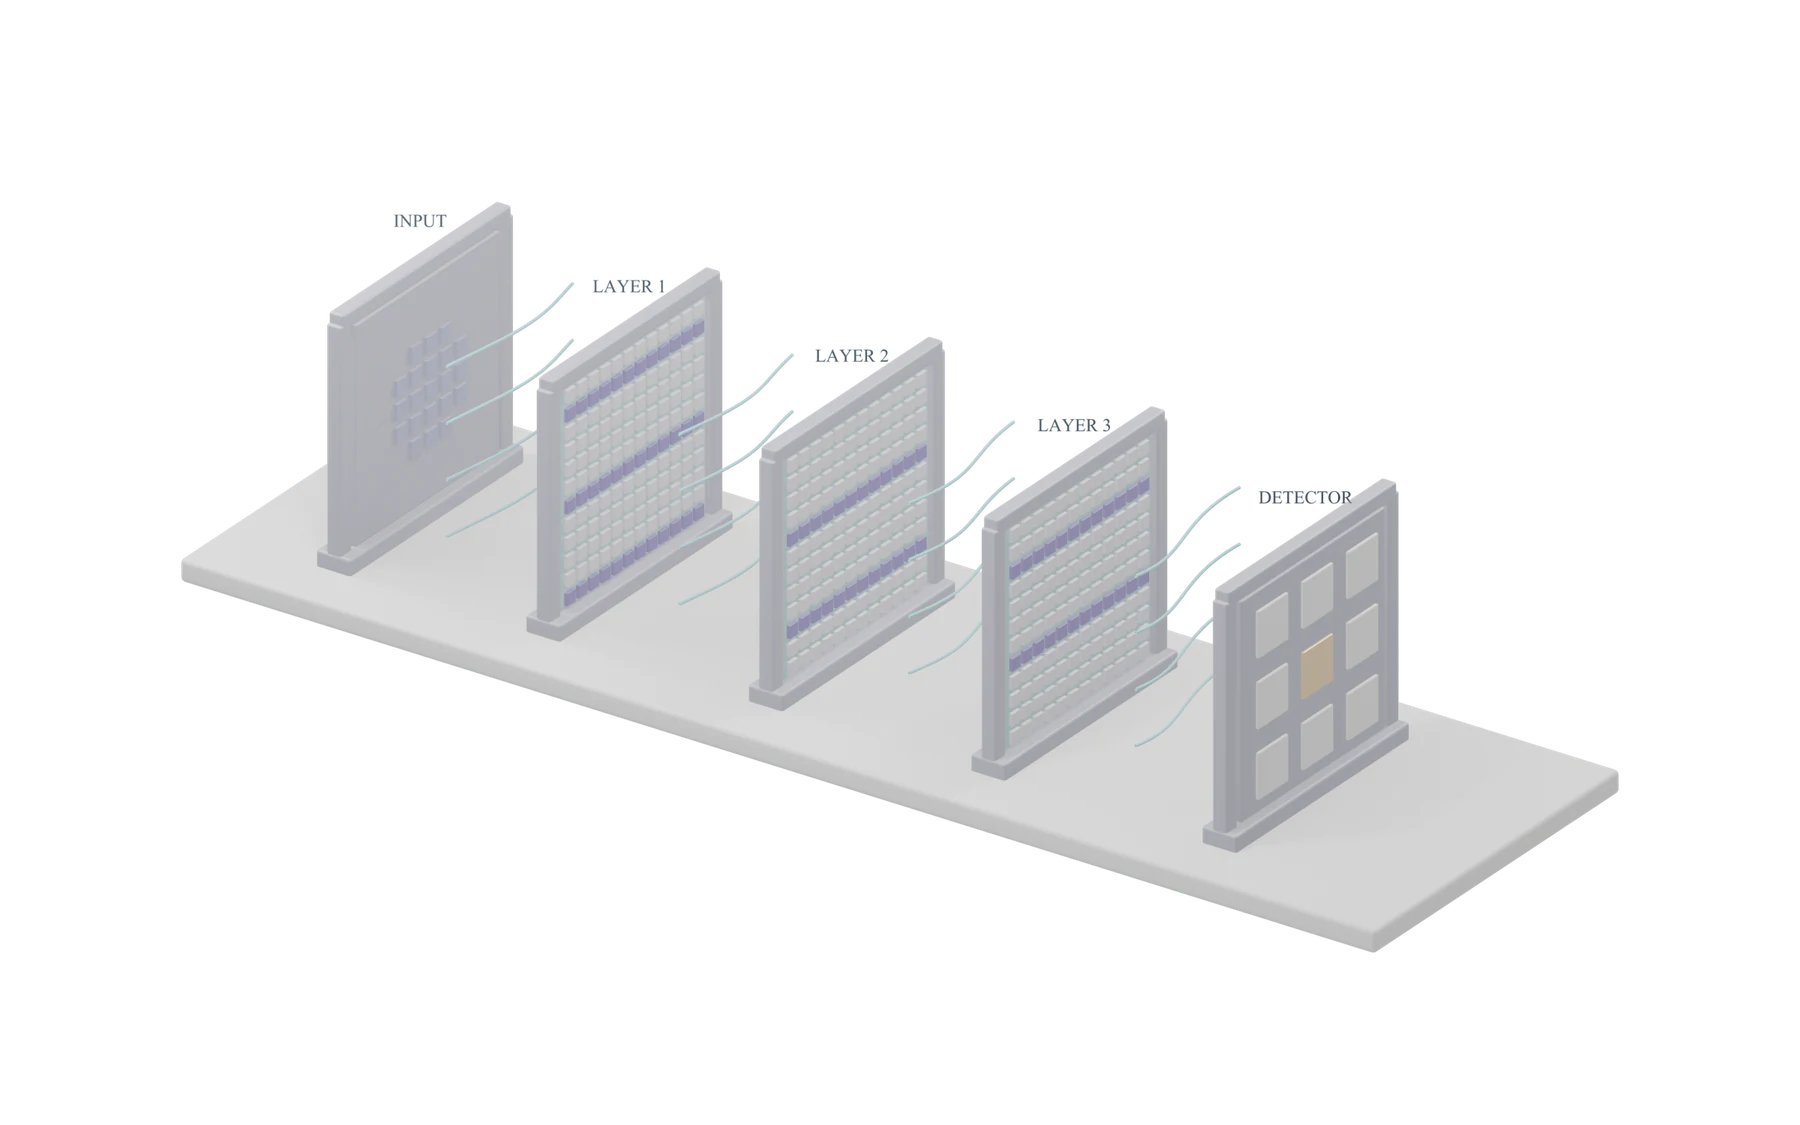
衍射网络的三维结构示意。输入光场依次经过三层空间调制与传播,输出平面设置多个探测区域。曲线表示传播中的波前,单元颜色和几何比例用于区分结构。
多层衍射结构可通过数值优化将输入图案映射到指定的输出区域,随后利用制造的器件完成物理传播与分类读出(Lin et al. 2018)。层间距离决定各调制区域的耦合关系,输出区域的位置与大小则决定传播结果如何转化为任务信号。
固定器件中的参数由制造结果决定,适合任务较稳定的场景;可重构调制器可以改变空间透射或相位,便于切换任务,同时需要驱动、刷新和校准。片上衍射器件将传播区域与调制单元集成在芯片上,缩短器件尺寸并改变空间耦合方式。具体系统对输入模式、加工误差和输出耦合的要求取决于其结构(Zhou et al. 2021; Zhu et al. 2022; Fu et al. 2023; Cheng et al. 2024)。
传播连接、参数数量与分类读出#
衍射网络的局部调制参数与层间连接具有不同来源。调制面上的某个像素通常提供一个相位或一个复透射系数,光传播把该像素与下一平面上的许多位置连接起来。离散表达可写为 ,其中 是局部调制构成的对角矩阵, 是由几何布局和波长确定的传播矩阵。因此,大量传播连接可以由少量可调参数共同控制,连接数与独立可训练参数数目应分别报告。把所有传播路径计为独立权重,会高估硬件的可编程自由度(Lin et al. 2018; Hu et al. 2024)。
层间距离影响横向耦合范围。光经过较长距离时,来自局部区域的衍射场可以覆盖更大的横向范围,有限孔径收集的功率则随几何条件改变。缩短距离可以压缩系统纵向尺寸,但相邻层之间有效互连的范围和强度也随之变化。层宽、像素间距、工作波长和信噪比共同决定实际可利用的连接。Lin等(Lin et al. 2018)的分类器与成像器采用不同层间距离,其设计服务于各自的任务和耦合需求。传播距离因此属于与任务共同优化的几何参数,改变这一距离会同步改变耦合和光能分配。
多层调制增加了构造目标光场映射的方式。单个相位面直接改变局部相位,随后传播把相位差转换为空间能量重新分配;继续增加调制面,能够再次调整已经混合的场分量。对有限像素、有限孔径和相位范围受限的器件,这种逐层处理可以提高目标变换的拟合质量。整个传播链的复场线性性质与其参数化表达能力分别描述两项属性,前者由叠加原理决定,后者取决于可调面数、空间采样和结构约束(McNeil et al. 2024; Wang et al. 2026)。
输入输出模式的定义决定如何检验一个衍射算子。对于目标矩阵,可以逐个激励输入基底并记录输出,重建相应的传输响应;对于分类网络,读出区域中的能量分布则与类别判决直接相关(Lin et al. 2018)。输入像素在相邻区域之间存在空间耦合,孔径和衍射会影响可分辨的空间细节(Hu et al. 2024)。增加版图像素可以改善调制轮廓,而可独立传输的信息维度还取决于输入输出孔径与传播过程共同形成的空间带宽。因此,制造分辨率的提高能否转化为更多可用通道,需要结合整个光路分析。
分类器可以通过训练把同类输入的输出能量集中到同一检测区域。设第 类的读出信号为 ,常用判决为 。这种读出用少数测量通道替代整幅输出图像的数字重建,适合类别较少、输出形式固定的任务。检测区域之间的间距、面积及对比度会影响误差容限。训练时加强正确区域的光能或增加正确与错误区域之间的信号间隔,可以提高决策在探测噪声下的稳定性;其代价包括牺牲其他空间位置上的输出自由度(Lin et al. 2018; Zhou et al. 2021)。
固定衍射层与可重构处理单元#
固定衍射层把训练参数编码为厚度、折射率或表面微结构。对给定材料与波长,局部相位延迟与光程差相关;材料吸收又使厚度变化伴随振幅变化。训练阶段若用纯相位模型,制造后应检查实际透射幅度的变化范围。经典太赫兹演示采用三维打印结构,验证了数值优化的空间调制可以通过实体传播形成分类和成像结果。该路线将器件设计问题与任务损失联系起来,固定器件的可复用性则依赖任务分布和环境条件的稳定程度(Lin et al. 2018)。
表面结构的工作模型还受尺寸与局部耦合影响。当单元尺寸接近或小于波长时,相邻单元的电磁耦合、偏振选择性及反射可以改变等效透射系数。独立像素近似需要用单元响应或更完整的电磁计算检验。超表面提供较丰富的振幅、相位和偏振设计自由度,其可用参数通常具有结构相关的耦合关系。训练时采用可制造单元库或受约束的响应模型,可以把优化空间与真实器件联系起来。面向大面积制造,还应检查重复单元误差、层间平行度及对准容差(McNeil et al. 2024; Hu et al. 2024; Park et al. 2026)。
可重构衍射处理单元把输入编码、可调波前和探测读出组合为可重复调用的模块。Zhou等(Zhou et al. 2021)使用数字微镜器件加载二值振幅图案,利用相位型SLM调节波前,再由相机读取传播后的光强。电子控制负责缓存、层间数据组织和参数刷新,光学传播承担空间混合。探测结果重新加载后,可以形成多层前馈结构;把先前状态与当前输入按计算图组合,又可以形成循环结构。同一组物理器件因此对应多种逻辑网络,所需调用次数和数据搬运量随模型改变。
这一模块化结构也便于校正数值模型与实体装置之间的偏差。Zhou等(Zhou et al. 2021)先完成数值预训练,再记录某层的实际输出,把测量结果作为后续层重新训练的输入,逐层补偿系统误差。这种自适应训练利用真实传播结果约束后续优化,其数值梯度和参数更新仍在电子侧完成。实验中,三层光电衍射网络在独立MNIST测试集上的准确率随校准流程发生明显变化,显示输入加载、像差和层间误差累积会直接影响分类。比较不同训练方案时,应记录实际测量位置和被重新优化的参数集合。
片上衍射的两种实现思路#
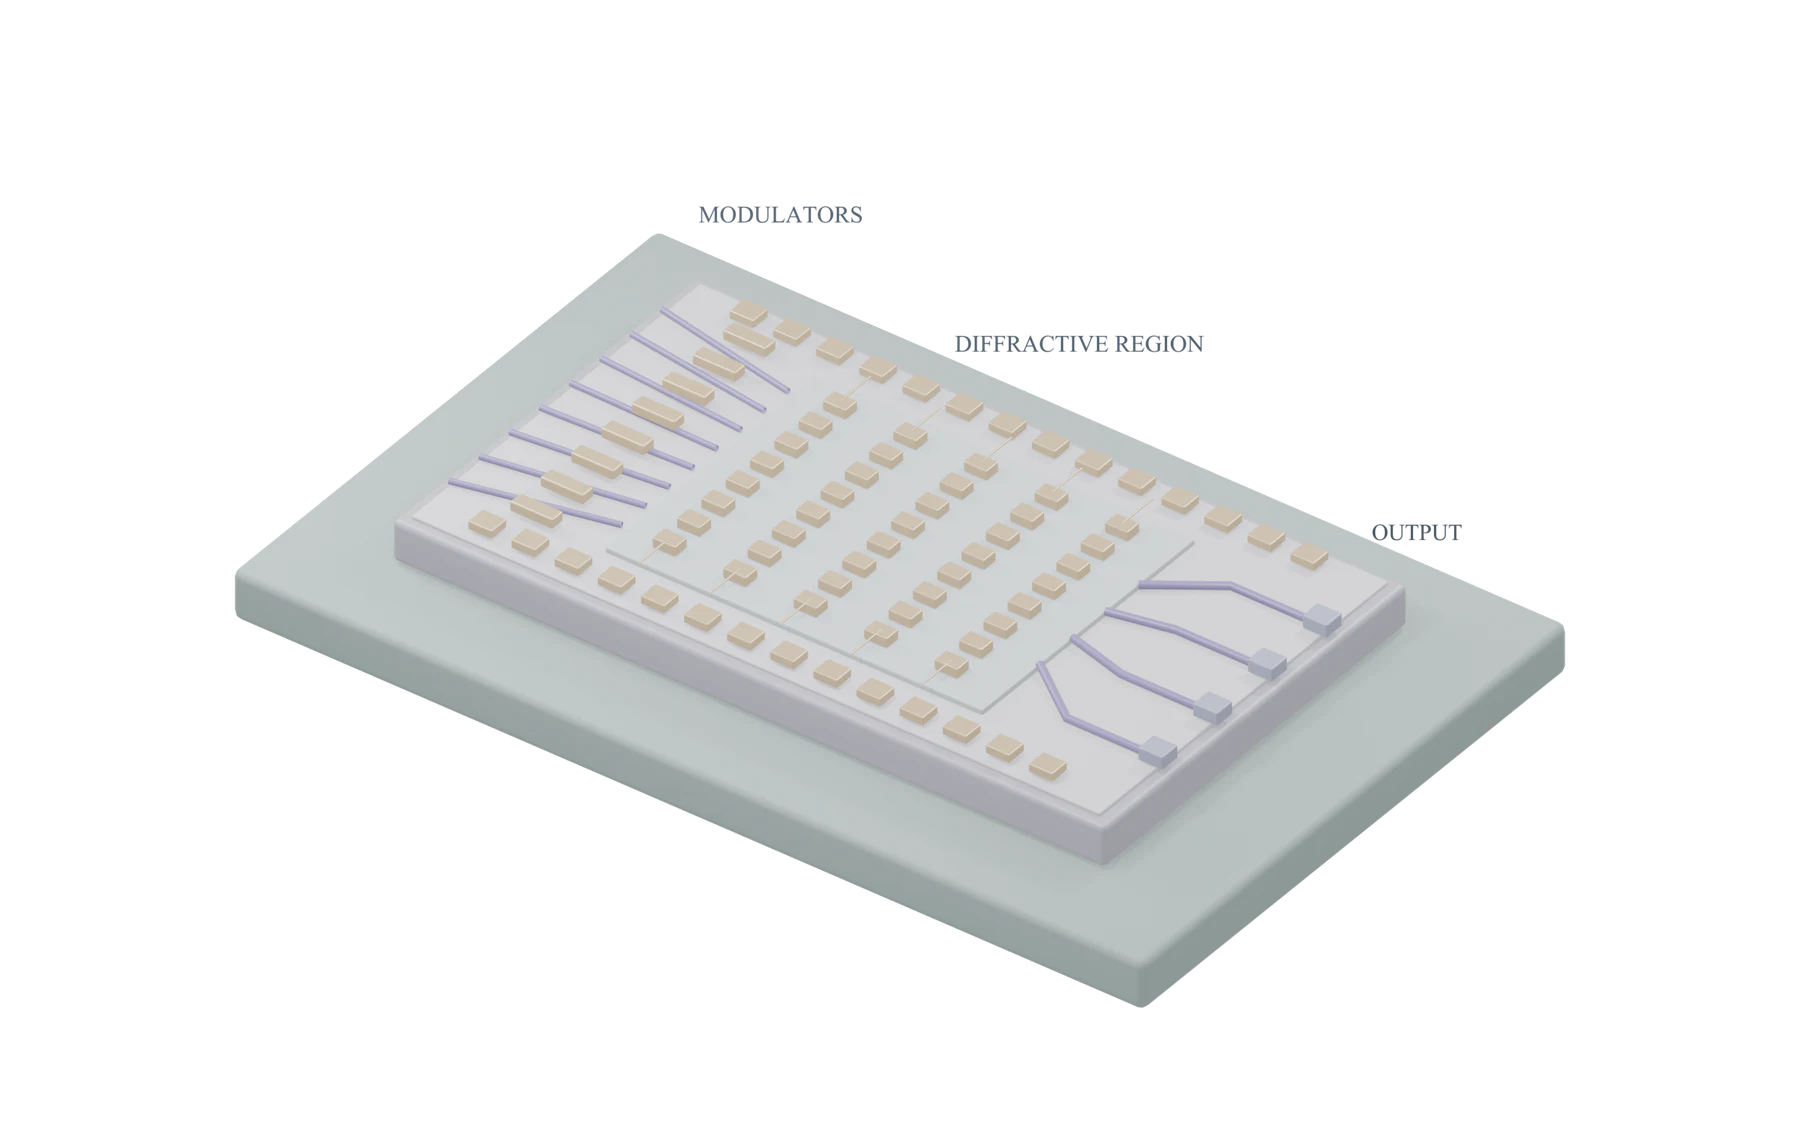
片上可调衍射网络的结构示意。输入调制器将数据加载到波导,平板传播区域中的可调单元改变光场,输出波导将结果送往读出端。图中单元数量用于说明结构。
片上衍射把横向传播限制在平板波导内,利用片上输入波导、空间传播区和输出端口完成场映射。Zhu等(Zhu et al. 2022)的结构采用两段衍射单元分别形成离散傅里叶变换与逆变换,并在中间设置复幅度调制。其线性核心可概括为 ,其中 是频域权重。这个算子具有循环卷积结构,固定傅里叶部分提供全局混合,可训练参数集中在频域调制单元。该设计在算子满足结构约束时减少调谐器件,层间探测和再次加载则构成完整的多层流程。
另一种选择是把训练得到的相位分布直接写入器件几何。平板波导中的硅槽组改变局部有效折射率,其长度由预训练结果确定;由此形成的固定调制层将优化后的映射保留在传播结构中(Fu et al. 2023)。对MNIST的片上分类,图像先经电子全连接层压缩为十个特征,再送入十路光学输入;在输入相位和输出功率补偿条件下,随机选取的100个测试样本达到86.0%准确率(Fu et al. 2023)。这一设计将稳定的空间混合交给固定器件,同时保留输入与读出端的调节自由度。
若传播区中引入热光调节单元,隐藏层本身便可随着训练反馈而改变。具有十六路输入、五层可调单元和四路输出的片上衍射网络,通过电子控制调整相位,并利用实际检测信号更新参数(Cheng et al. 2024)。这样,制造后的器件可以针对新任务重新配置,实际响应也能够进入优化过程;相应地,控制线路、热稳定时间与维持相位所需的功率成为系统设计的一部分。
结构化傅里叶算子、固定几何调制和可调衍射层由此形成一条连续的设计谱系:控制集中在少数频域权重时,器件利用算子的结构减少可调自由度;将权重写入几何结构时,任务映射主要由制造确定;将调节单元分布在隐藏层时,配置能力扩展到传播过程内部。任务所需的变换范围、参数更新频率及可接受的控制资源共同决定合适的选择。
波长、偏振与相干条件的扩展#
宽带衍射设计需要共同处理材料色散与传播色散。Luo等(Luo et al. 2019)把不同频率的光传播纳入同一训练目标,以局部结构厚度为共享参数,设计并实验验证了单通带、双通带滤波及空间波长解复用器。相同厚度在不同波长处对应不同相位和透射率,网络通过优化这些关联响应实现目标光谱。训练中通带选择性与有效输出功率存在权衡,损失函数的权重会改变最终器件的带宽与光效率。该工作也说明,衍射网络的任务范围包含确定性光学变换,性能评价可以使用通带和效率等光学指标。
把不同任务分别分配给波长通道,需要共同优化共享的衍射结构。Duan等(Duan et al. 2023)以数值研究比较多波长联合训练与单波长多任务处理,任务来自MNIST、Fashion-MNIST等数据集。其模型在输出端划分任务对应的检测子区域,并讨论波长选择滤波对串扰的影响。该方案的成立依赖多波长相位响应与制造设计相匹配;原文中的共同相位调制假设应随结构实现一并检验。扩大通道数后,更多任务共享有限可调参数,优化容量与输出区域资源也随之成为约束。
偏振复用采用另一组可区分的光学通道。Li等(Li et al. 2022)在各向同性衍射层之间加入预定方向的线偏振片阵列,使输入与输出偏振组合对应不同的复线性变换。其数值验证比较了顺序访问与并行访问,并分析训练参数数量、变换误差和通道串扰。偏振片阵列提供偏振相关响应,可训练衍射层与之共同形成目标变换;偏振态的设置与偏振选择器件的响应共同决定各通道的计算功能。
空间非相干照明把任务变量自然地转向时间平均强度。Rahman等(Rahman et al. 2023)通过数值研究训练多层相位衍射结构,使其强度点扩散函数逼近目标非负矩阵,并扩展到多波长和图像分类。该模型依赖随机相位平均和相应的积分时间;有限时间的实际光源还需要检查互相干函数、光谱与探测噪声。对于自然场景的处理,光源相干性、背景光和输入物体的波长响应可直接进入任务模型。由此形成的设计问题连接了衍射计算与成像系统的光源、孔径及采样条件。
多自由度设计的评价可以围绕同一组条件开展。先给定总入射功率、可调参数数目、输入模式数和探测通道数,再比较各任务的误差、有效光能占比和串扰。这样的约束能说明波长或偏振复用具体增加了哪些并行功能,也能显示信号在共享孔径和探测区域之间的分配代价。对于仅经数值验证的设计,实验实现需要进一步给出光源组织、分波或偏振选择器件、制造响应和读出路径。设计模型与这些环节的匹配程度,决定复用能力能否转化为稳定的系统吞吐(Li et al. 2022; Rahman et al. 2023; Duan et al. 2023)。
马赫–曾德尔干涉网络#
马赫–曾德尔干涉仪(Mach–Zehnder interferometer,MZI)由两条干涉臂和耦合器构成。输入光被分配到两条路径,经过相位调节后重新耦合。调节两臂相位差可以改变输出端的光功率分配。若把两个输入和输出通道看作一个复向量,这一器件可实现可调的二维线性变换。大量可控单元组成网格后,可以构造更高维的酉变换(Clements et al. 2016; Shen et al. 2017)。
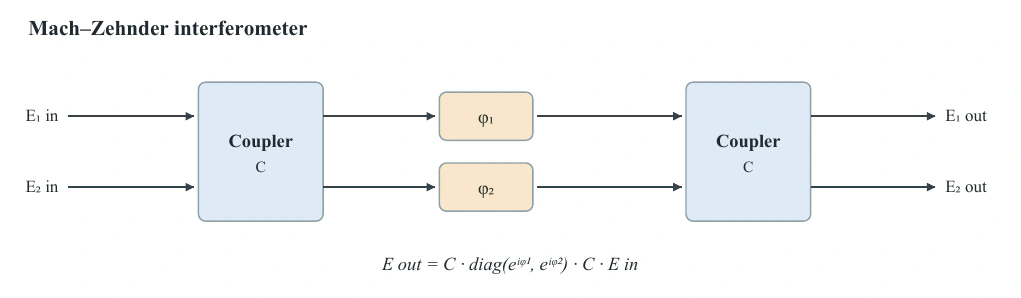
马赫–曾德尔干涉单元示意图。两路光在耦合器中混合,臂间相位差控制两输出端的相干叠加。
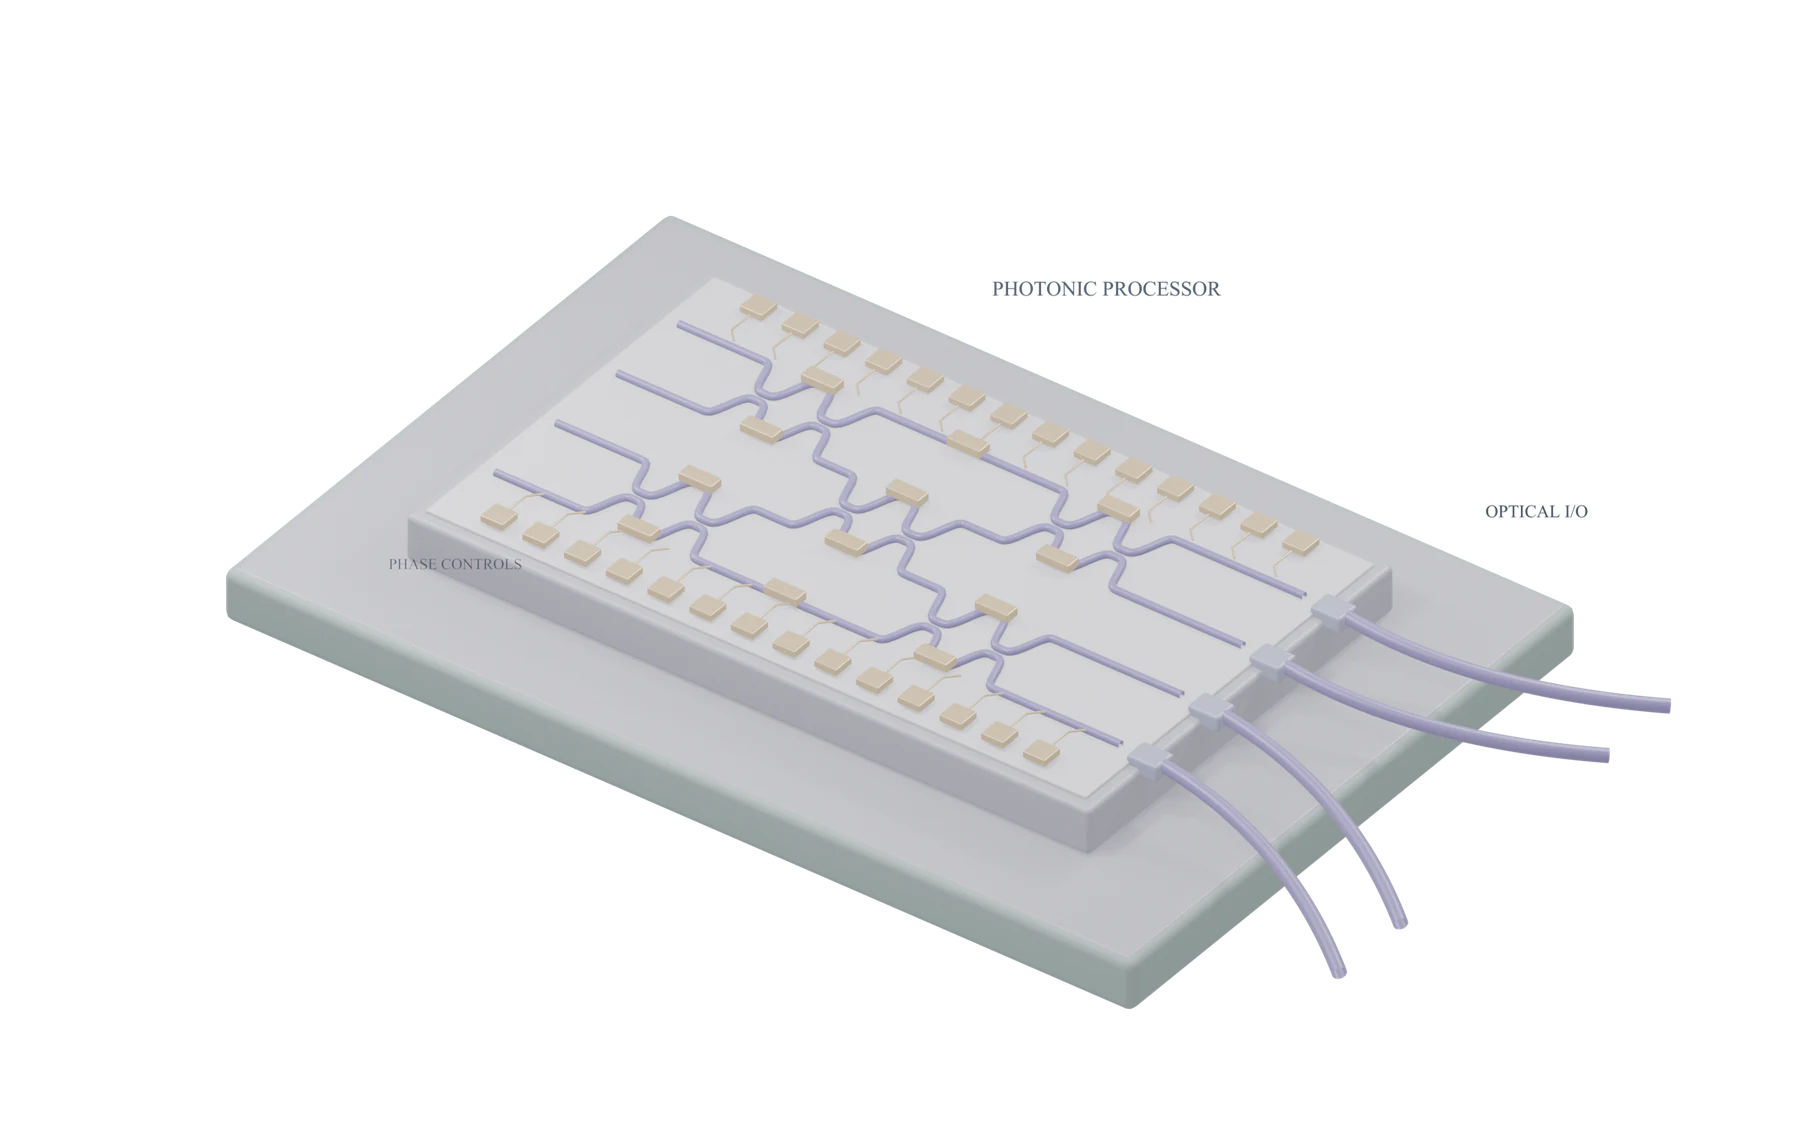
集成干涉网络的三维结构示意。芯片上的多条波导在耦合区靠近,相位调节单元控制光场的相对相位,多个可调单元共同形成多通道变换。图中几何尺寸用于展示器件关系。
对于一般复矩阵,可利用奇异值分解 理解实现方式:两个酉变换由干涉网络实现, 对各通道进行幅度缩放。真实网络还要处理耦合误差、插入损耗、有限相移范围和器件间热串扰。输出功率随通道数与级联深度变化,系统精度和能效由矩阵实现、读出及控制环节共同决定(Zhou et al. 2022)。Shen等(Shen et al. 2017)的相干纳米光子电路展示了利用可调干涉网络处理神经网络计算的实验路线。
为了理解MZI的调节作用,可将理想的两端口耦合器写成矩阵 ,两臂相移写成对角矩阵。器件的整体传输可表示为
其中 和 是两臂的相移。两束光在第二个耦合器处相加,其相对相位 改变输出端的振幅。实际相移器可通过加热、载流子或其他方式调节折射率;不同调节方法对应各自的速度、功耗和器件设计。系统校准需要测量耦合器和相移器在工作范围内的真实响应(Zhang et al. 2025)。
干涉网络的输入通常由多个波导模式组成。每个相邻通道上的可调单元完成局部混合,多个层级再将信息传递到更远的通道。单元数量随矩阵维度增加,器件损耗和相位控制通道也随拓扑扩展。针对固定输入功率,设计者需要估计光经过网络后到达各探测端的功率,进而确定所需增益和积分时间。若网络采用热相移器,相邻元件的温度变化还会影响其他位置的相位,因而需要通过标定或反馈协调多个控制量。
矩阵分解提供了从目标权重到光学参数的映射方法。以奇异值分解为例,酉矩阵描述模式之间的能量重新分配,奇异值决定沿相应模式方向的幅度比例。实际神经网络权重还可能包含正负实数,输出端需要合适的相位参考或差分测量以恢复所需符号。光电转换后形成的数值还受到探测器线性范围影响,因此模型映射、器件设置与读出方式需要一起设计。
集成架构中的数据路径与权重实现#
理解片上网络需要追踪信号进入芯片、经过权重元件、到达探测器以及重新生成光信号的过程。干涉网格以复振幅和相位承载计算,微环权重库常以不同波长的光功率表示输入。两种编码给器件控制和输出测量提出各自的要求:相干网格需要维护相关通道的相位关系,功率编码系统需要定义各波长的加权、求和和符号表达。器件之间的连接与任务数学模型由此形成明确对应(Zhang et al. 2025; Tait et al. 2017)。
干涉网格中的一个可调单元可看成对两维模式空间进行局部旋转。依次选择参与混合的通道对,可以把多个局部变换组合为高维酉变换。Clements等(Clements et al. 2016)讨论的多端口干涉仪采用规则的网格结构,使不同路径经过相应的可调单元。在实际芯片上,耦合器的分光比、相移器的响应曲线与波导损耗共同决定实现矩阵。设计者可先测量单元响应,再用矩阵分解或整体优化确定控制参数。
一个具有 个输入和 个输出的通用酉变换包含随维度增长的相位自由度。通道数扩大时,调制器数量、驱动接口和校准工作也会增加。规则网格适合表示一般酉变换;具有局部连接、稀疏矩阵或循环结构的任务可以采用与结构相适应的光路,减少部分物理资源。比较方案时应把模型允许的权重集合与分类或预测性能一起报告(Zhou et al. 2022; Zhang et al. 2026)。
MZI网络的光学输出通常是复场。若任务需要读取复场的某个实数分量,可将信号 与参考场 干涉,并利用两路功率之差提取相位相关项:理想归一化下,。参考场的相位确定被读取的正交分量,参考功率和探测噪声则影响测量范围。另一种方式是让模型直接使用探测光强作为输出,此时训练中的读出函数需要包含模平方。
傅里叶光学与卷积#
在4光学系统中,第一片透镜把输入分布变换到傅里叶平面;该平面上的滤波器调节各空间频率分量;第二片透镜形成相应的输出分布。在合适的系统条件下,卷积定理给出
这里 为输入、 为卷积核, 表示傅里叶变换。这个关系说明空间卷积可以转换为频域逐点相乘。实际系统的孔径、像差、滤波器动态范围和输入输出采样会限制其精度(Fu et al. 2024; Zhou et al. 2022)。完整卷积神经网络还需安排通道组合、非线性、层间数据传递和输出判读。
在理想的相干4系统中,第一片透镜后的频域平面可放置振幅或相位滤波器。滤波函数决定各空间频率的透射系数,因而决定输出对应的空间算子。透镜之间的几何距离与焦距共同决定各平面的位置;图像输入、频域滤波器和输出传感器的像素采样也会影响可表达的卷积核。对多通道神经网络,系统需要组织多组输入特征和卷积核,再在输出侧完成通道组合。
若滤波器采用可编程空间调制器,更新卷积核的速度受器件刷新率和控制数据传输限制。固定滤波器适合重复执行同一算子,可编程结构则便于改变权重。训练阶段可将滤波器的振幅约束、相位范围、孔径和采样误差写入模型,使优化结果更贴近实际器件。实验评估还应记录照明的波长与相干条件,因为频域位置与波长、焦距之间存在对应关系。
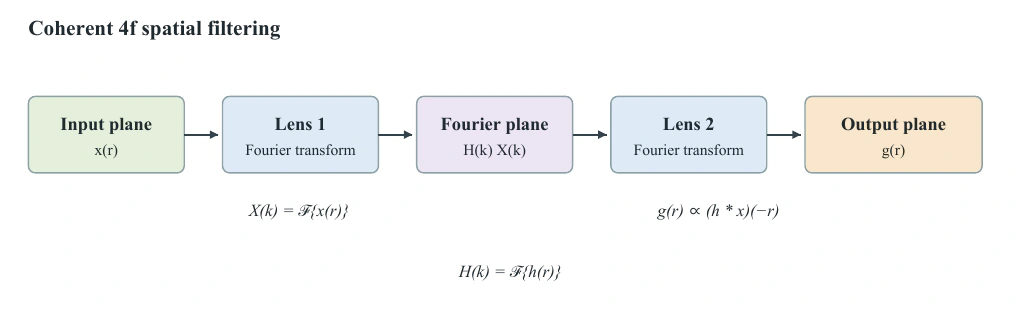
4系统的频域滤波示意。两片透镜分别执行傅里叶变换,输出平面含坐标倒置;采用一致的坐标约定后可解释为相应的卷积处理。
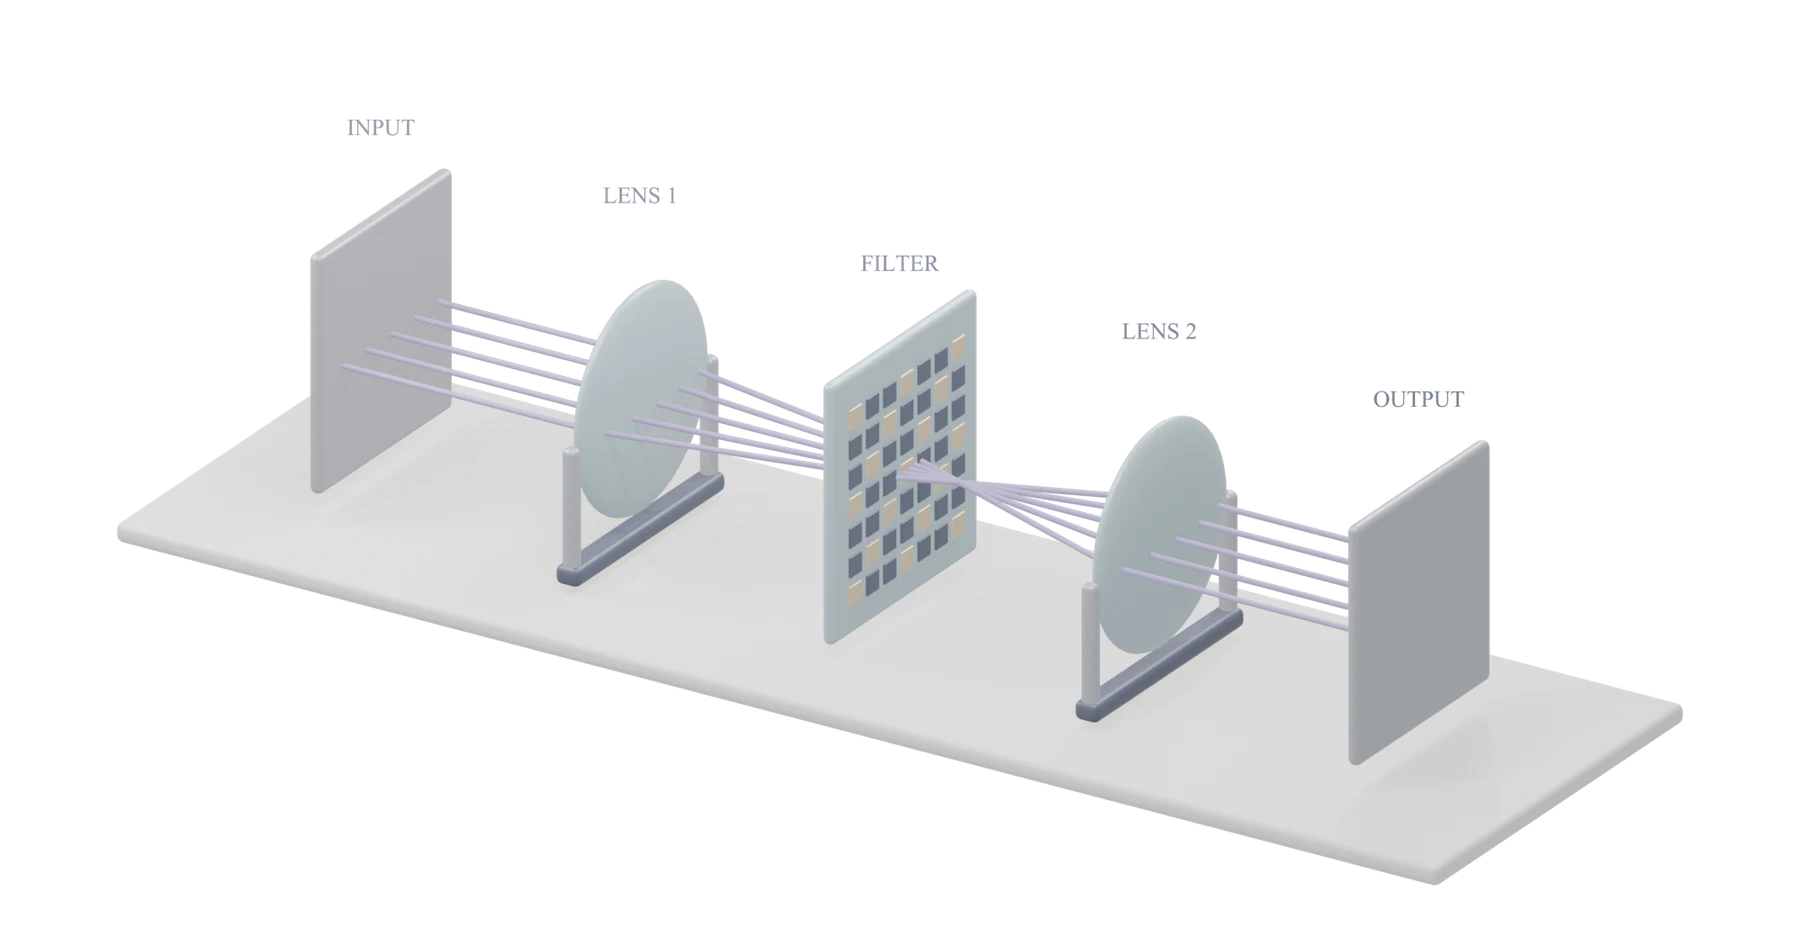
4光学系统的三维结构示意。输入平面、第一透镜、频域滤波平面、第二透镜和输出平面沿光路依次排列;曲线用于指示光路方向。
4系统的相干传递函数与实现条件#
4结构把空间传播的几何关系组织为两个傅里叶变换。设输入复场为 ,第一透镜的后焦平面坐标为 ,理想近轴条件下,该平面的复场与输入的空间频谱成比例,空间频率与坐标的关系可写作 、。这里 为焦距, 为工作波长。频域平面上的位置由此对应输入中的一个空间频率分量(Fu et al. 2024; McNeil et al. 2024)。
将复透射函数 放在频域平面后,输出场可按坐标约定表示为
其中输出坐标按照系统倒像关系重新定义。若 ,输出可写为 。这个关系描述复场的相干处理,光强读出还要对输出复场取模平方。若输入数据直接由光强编码,训练模型需要涵盖数据编码、复场传播与光强检测的完整映射。
频域滤波器的物理可实现范围由材料透射率、相位调制区间和像素尺寸确定。对被动滤波器,透射幅度落在器件允许的范围内;目标频率响应可以按系统增益进行归一化。相位型调制器主要改变光程,复振幅响应可以通过结构设计、编码或多个调制阶段构造。若算法训练得到的频域权重具有较大的动态范围,还需要结合探测噪声和光功率重新评估小幅度频率分量的可测性。
图像的边界处理会影响物理卷积。数字卷积常规定零填充、周期延拓或特定边界裁剪;光学系统的有效输入范围由照明区域、器件孔径和探测窗口共同确定。将输出与数字参考比较时,应在相同坐标、采样间距和边界规则下计算误差。若输入像素太密或频域采样范围较小,部分空间频率会受到孔径和采样约束,输出图案的细节随之改变。
多通道卷积可由多个光路、多个波长或时间片组织。设输入具有 个通道、输出具有 个通道,数字模型通常对每个输出通道汇聚 组卷积结果。光学系统需要确定各输入如何加载、各卷积核如何设置,以及输出在何处相加。并行复制光路可以缩短部分调度时间,时间复用可以共享器件;两种方法的功率、对准和读出资源应按具体实现记录。
微环、波分复用与光学张量计算#
波分复用(wavelength-division multiplexing,WDM)使用不同波长传输多路信号。各通道可以经过可调器件独立加权,并在探测端汇聚。微环谐振器(microring resonator,MRR)的透射响应随波长和谐振状态变化,因此可以构成波长选择性权重单元。多通道权重库的操作依赖光源、调制器、微环调谐及探测读出的协同(Tait et al. 2017)。
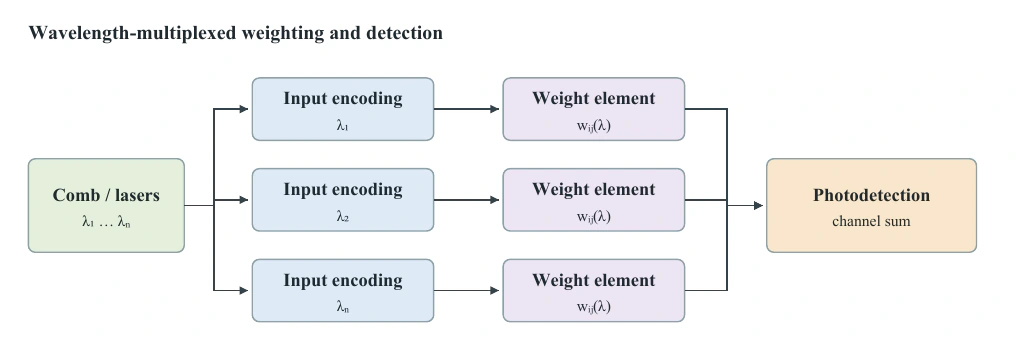
波分复用加权的概念示意。多个波长通道承载输入并分别加权,光电探测器汇聚通道信号;通道加权与求和方式由器件和探测条件决定。
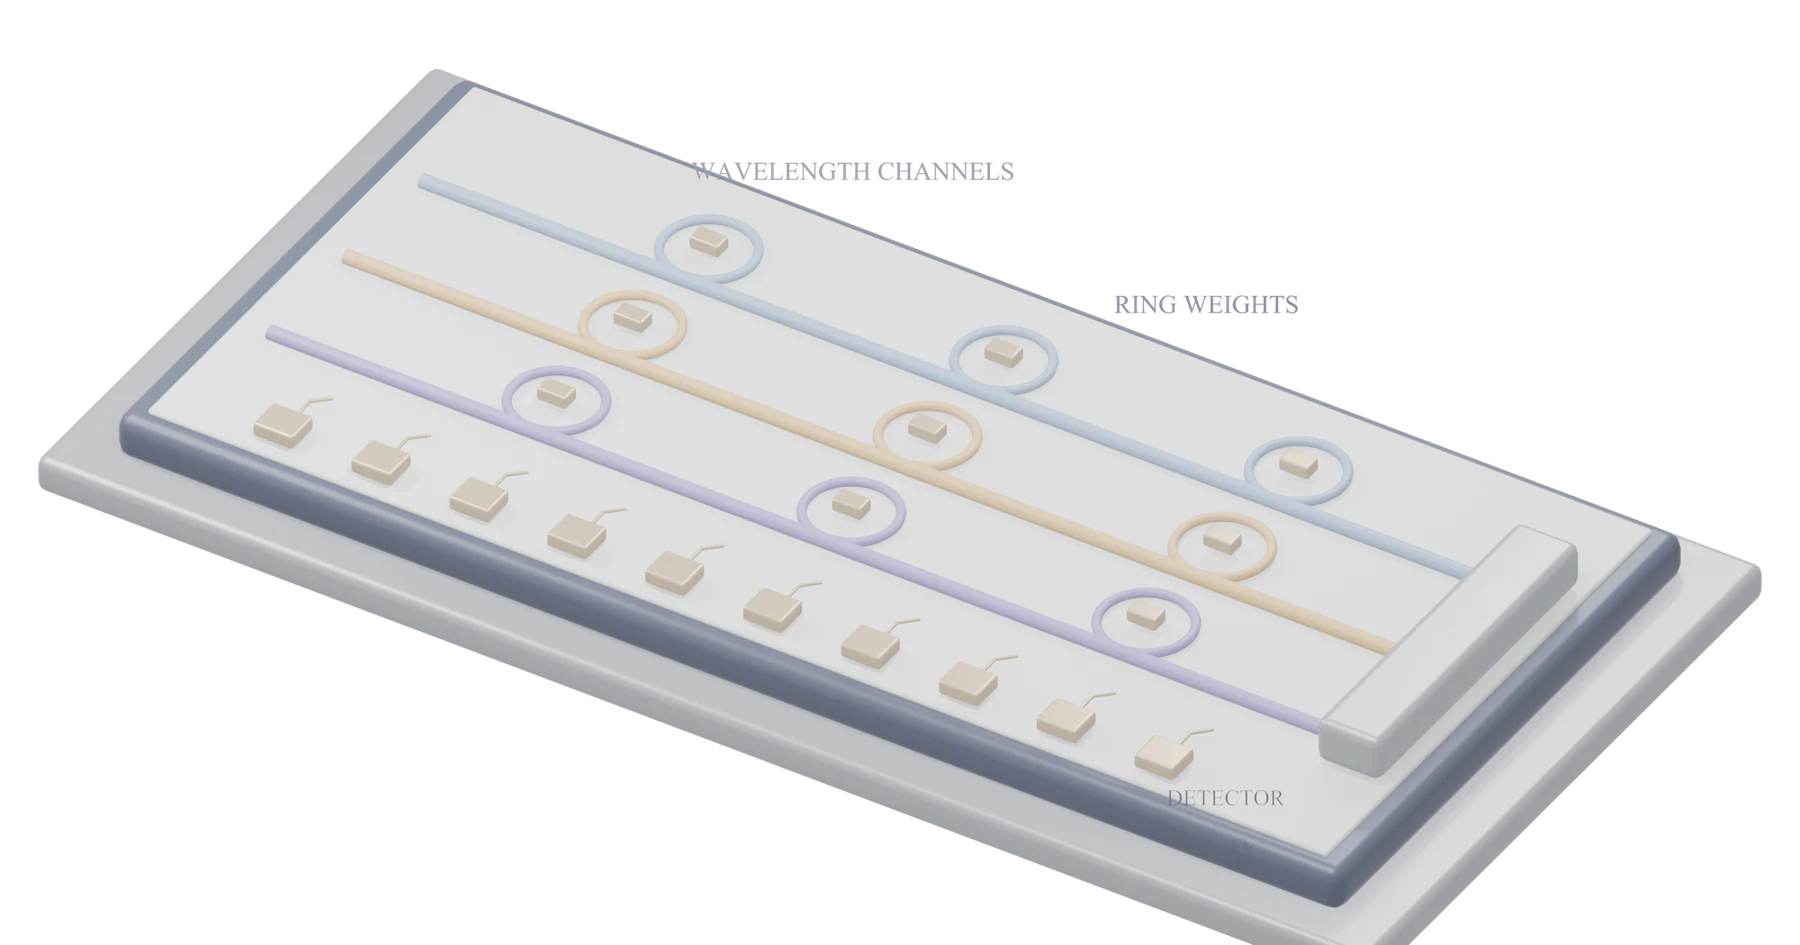
微环加权结构的三维概念示意。波导与微环形成波长选择性耦合,调节单元改变微环响应,输出端汇聚信号。颜色标示示意通道,几何尺寸服务于结构表达。
微梳产生的一组频率间隔规则的谱线,为多波长并行提供了共同光源。各谱线可以承载卷积窗口中的加权项(Xu et al. 2021),也可以组织为经过共享权重阵列的多组输入(Feldmann et al. 2021)。波长通道在计算图中的含义由调制、分波和探测方式共同确定,谱线数量则与可并行的数据组织有关。
多波长信号进入探测器后,探测器的响应与接收光功率有关。当通道间差频超出读出电路带宽时,时间平均后的光电流可近似表示各通道贡献之和。该求和条件需要结合光源相干性和探测带宽说明。表示有符号权重时,可使用两条分别累加正贡献和负贡献的路径,再在电子域计算差值;具体系统的符号编码与读出电路由器件设计决定。
微环权重库、符号与输出再生#
微环谐振器可视为与总线波导耦合的封闭光学路径。光绕行一周后的相位由有效折射率、环长和波长决定;满足谐振条件时,环内场与总线中的场发生相干耦合。调节温度、载流子或其他器件状态可以移动谐振位置,使固定波长处的透射系数发生变化。将多个微环排列在波导附近,可以分别控制一组波长通道(Tait et al. 2017; Zhang et al. 2025)。
Tait等(Tait et al. 2017)研究的广播与加权结构以不同波长表示神经元输出,信号经波分复用后送入权重库。可调微环对各通道执行选择性加权,光电探测把光功率转换为加权电信号,后续电光模块再生成适合传播的输出。该研究通过单节点双稳态和双节点振荡的实验,将器件的动力学变化与连续时间循环网络的模型对应;求解微分方程的24节点网络及其相对于处理器的加速比属于仿真预测。区分实验规模与仿真规模,有助于将器件验证和系统级估算放在各自的条件下理解。
有符号权重可以通过两组非负光功率的差值表达。设第 个输入功率为 ,两组权重为 和 ,差分读出可写为
式中每组权重由可用器件的透射范围确定,差分系数对应目标实数权重。两组探测器的响应、暗电流和放大器增益会影响最终差值;训练或标定可以把这些参数写入模型。若使用单端输出,则可通过偏置和任务约束选择适合非负输出范围的表示。
输出再生决定网络能否继续驱动后续模块。电光再生将探测得到的电信号用于调制一个光载波,使下一层获得符合其输入格式的信号。再生过程的增益、带宽、噪声、光源功率和电路偏置都影响级联性能。若多个下游节点共享同一输出,光功率需要按扇出关系分配;每个节点的探测光子数与所需精度也随之变化(Shastri et al. 2021)。
微梳卷积的数据组织#
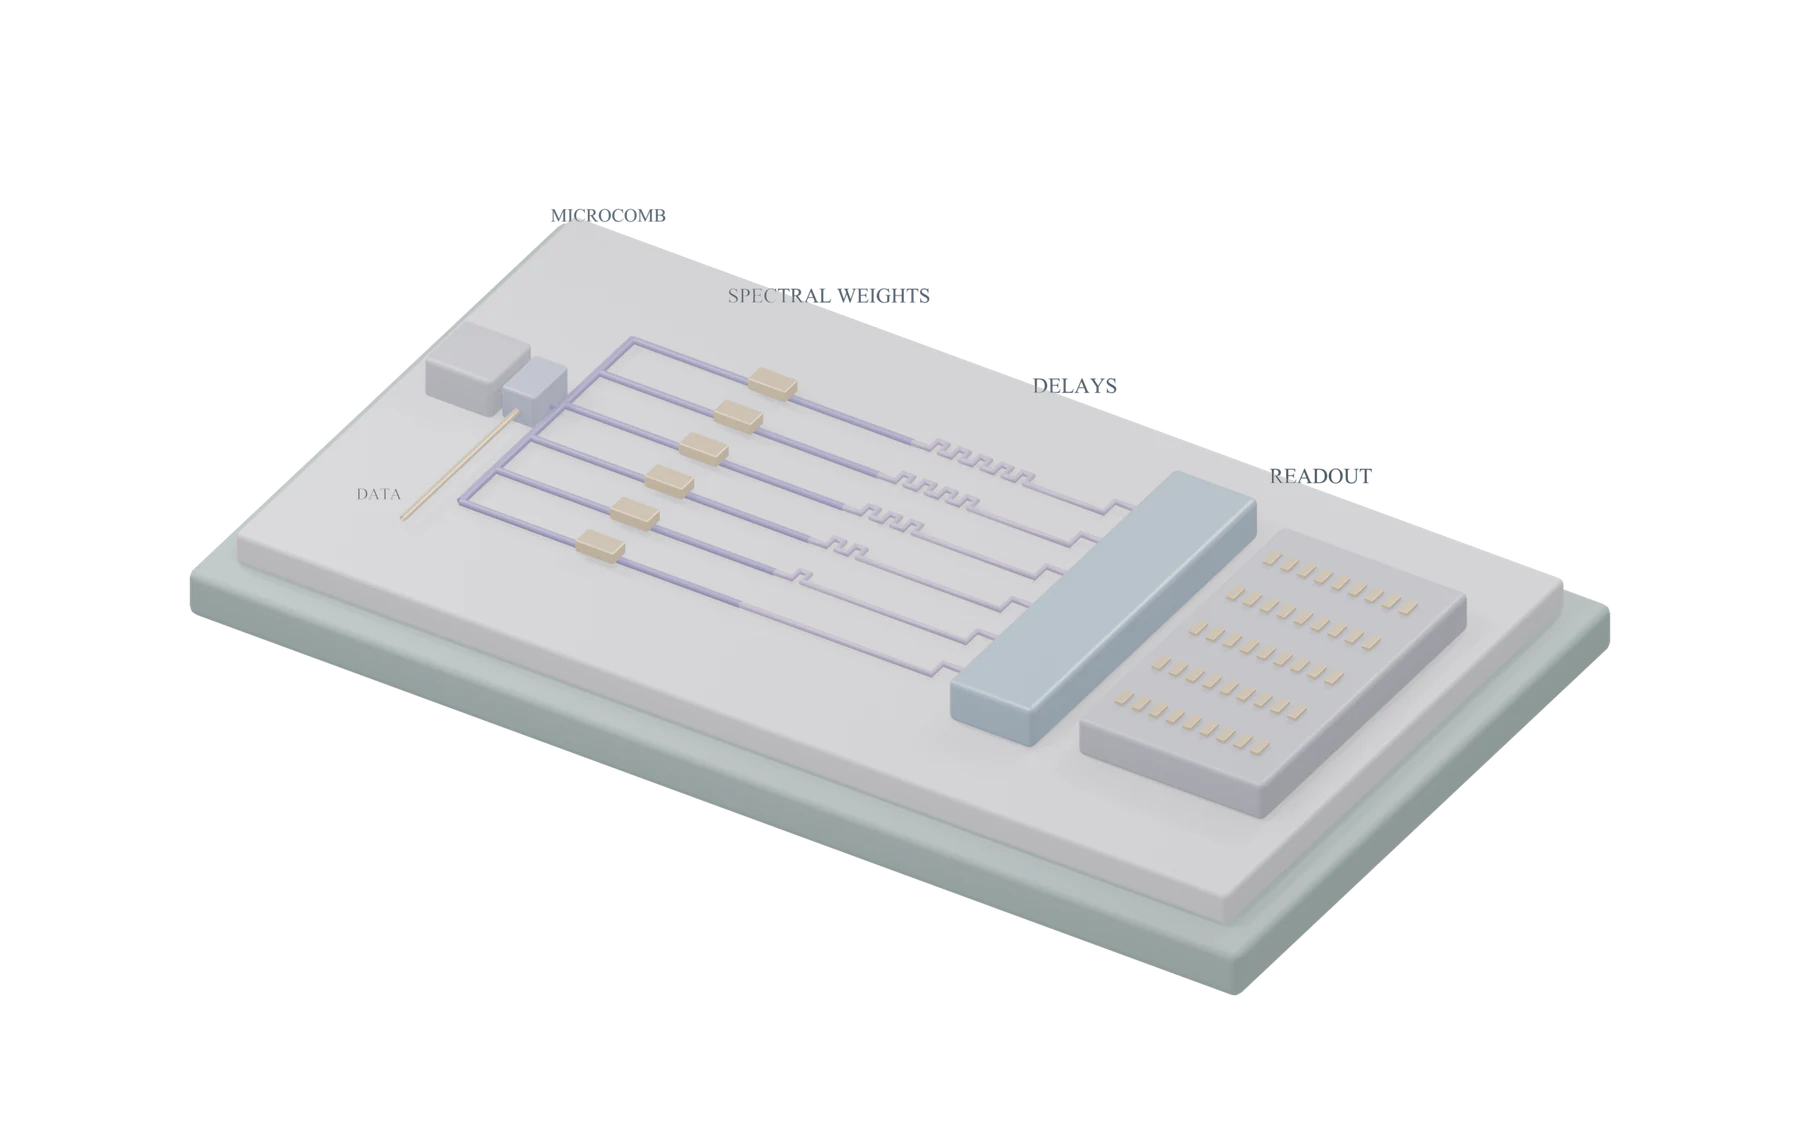
微梳卷积系统的结构示意。多个频谱通道经过权重调节与相对延迟,在探测与读出阶段形成加权汇聚信号。调制、分波、延迟和探测元件可按具体系统配置。
卷积可通过一组时间延迟和波长通道实现。首先,把输入序列加载到多个光谱通道;随后,各通道的幅度按卷积核系数加权,并设置相应的相对延迟。经探测汇聚后,某一时刻的输出对应一组不同输入位置的加权和。移动到下一个时间槽,窗口随之平移,从而得到下一位置的卷积结果。计算结构依赖输入采样、通道间延迟与探测带宽之间的配合。
若每个时间槽的长度为 ,并令第 个通道相对于参考通道延迟 ,第 个卷积核的离散输出可表示为
这里 为卷积核展开后的系数个数。色散或路径差把同一输入序列的不同位置对齐到一个探测时刻,光谱权重确定各项的系数。带符号权重可由两组光功率分别承载正、负分量,再经平衡探测形成差值;该过程的探测器匹配和噪声共同影响结果。Xu等(Xu et al. 2021)在图像卷积实验中采用了按权重符号分路并平衡探测的配置。
同一输入序列可以复制到多组谱线,使多组权重并行作用于数据(Xu et al. 2021)。对二维图像,还需将像素排列成时间序列;窗口滑动的实际顺序由展平方式和通道延迟共同决定。这个数据组织关系使向量计算速度与二维任务中的有效输出速度具有不同含义,具体映射见第5.4.2节。
微梳的光谱线间距与通道滤波器的带宽共同决定可用波长数。各谱线功率具有各自的分布,通道预均衡与输入调制范围会影响可达精度。时间延迟可由色散器件或波导路径差形成;器件损耗和延迟误差影响各通道到达探测端的功率和时序。完整卷积系统还涉及数字输入缓存、权重设置、采样和后续层处理,评价时需要按实验数据路径计算其资源消耗。
相变权重与片上张量核#
相变材料在不同结构状态下具有不同光学常数。将材料单元置于波导附近,传播光的透射率会随材料状态改变;经过校准,材料状态可以对应一个权重值。写入脉冲确定材料状态,读取光则用于测量或使用该状态。材料状态的变化过程涉及热量输入、冷却和器件循环,其稳定性与可分辨的权重级数共同决定可用精度(Feldmann et al. 2021)。
光子张量核将多个权重单元、波导连接和多波长输入组织为矩阵运算。Feldmann等(Feldmann et al. 2021)利用波导上的相变单元存储权重,并通过光学频率梳承载并行输入。输入、权重和检测输出之间的对应关系由波导阵列决定,探测结果形成乘加信号。分类实验还包含数据预处理和模型其他层,分析应用时需要明确光子核承担的算子。
权重保持时间影响材料器件适合的任务。模型长期使用同一组参数时,一次写入成本可以分摊到较多次读取;在线学习或频繁更换模型则需要更密集的写入与状态验证。多级权重的实际精度可通过逐级透射分布、重复写入误差和随时间漂移的测量表征。对大规模阵列,还需结合地址控制、写入选择性和单元间热串扰评价。
残差连接和可重构光子算子#
深层网络常用残差连接把某一层输入与处理后的输出组合。若处理函数为 ,输入为 ,一个简化残差块可记作 。这个表达式明确要求两条数据路径在相同输出坐标和数值尺度上汇聚。器件实现需要同时安排主计算路径、旁路、信号同步和输出读出。
在一种片上残差卷积映射中,一个波长承载旁路数据,四个波长承载 卷积窗口;相变材料单元提供权重,两条路径经波长选择和耦合后在输出端汇聚(Quan et al. 2026)。这种安排把网络图中的相加转化为不同物理路径之间的匹配问题:旁路必须与卷积输出对应同一空间位置,权重和传输损耗也需要共同确定两路信号的相对尺度。
旁路与卷积支路的相对延迟会影响对应像素的对齐;权重通道透射率、谱线功率和耦合器响应则共同决定汇聚后的幅度。若输出由宽带探测器读取,不同波长分量的拍频与探测带宽还会影响最终电信号。残差计算的精度因此取决于时序、幅度和读出条件能否同时满足数据路径的要求。
动力学与光电混合网络#
循环神经网络利用状态反馈处理序列。储备池计算保留一个具有复杂动力学的内部系统,通过训练读出层将状态映射为任务输出:
这里 为内部状态,、 和 分别对应输入、内部连接和读出。物理储备池中的状态由具体器件及其反馈或延迟机制形成。光学储备池和硅光子储备池实验展示了利用光学动力学处理时间序列的路径(Duport et al. 2012; Vandoorne et al. 2014)。
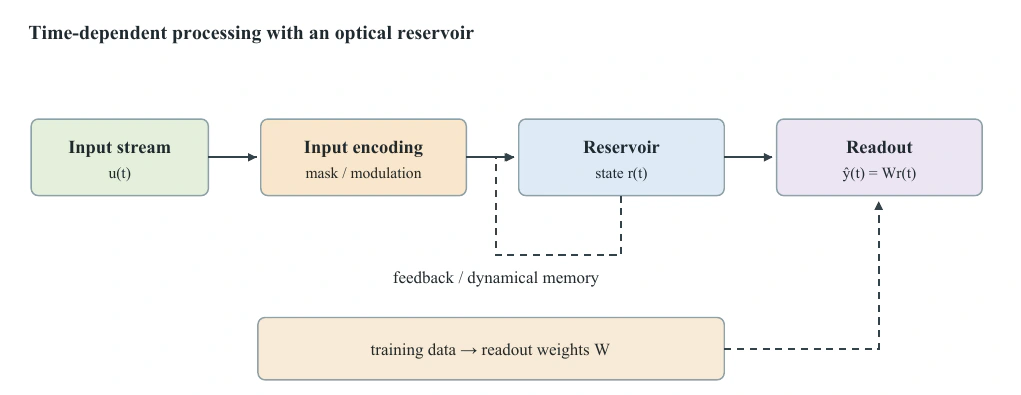
光学储备池的时序处理示意。输入驱动内部动态状态,读出层将状态映射为任务输出。状态演化可由反馈或器件动力学形成。
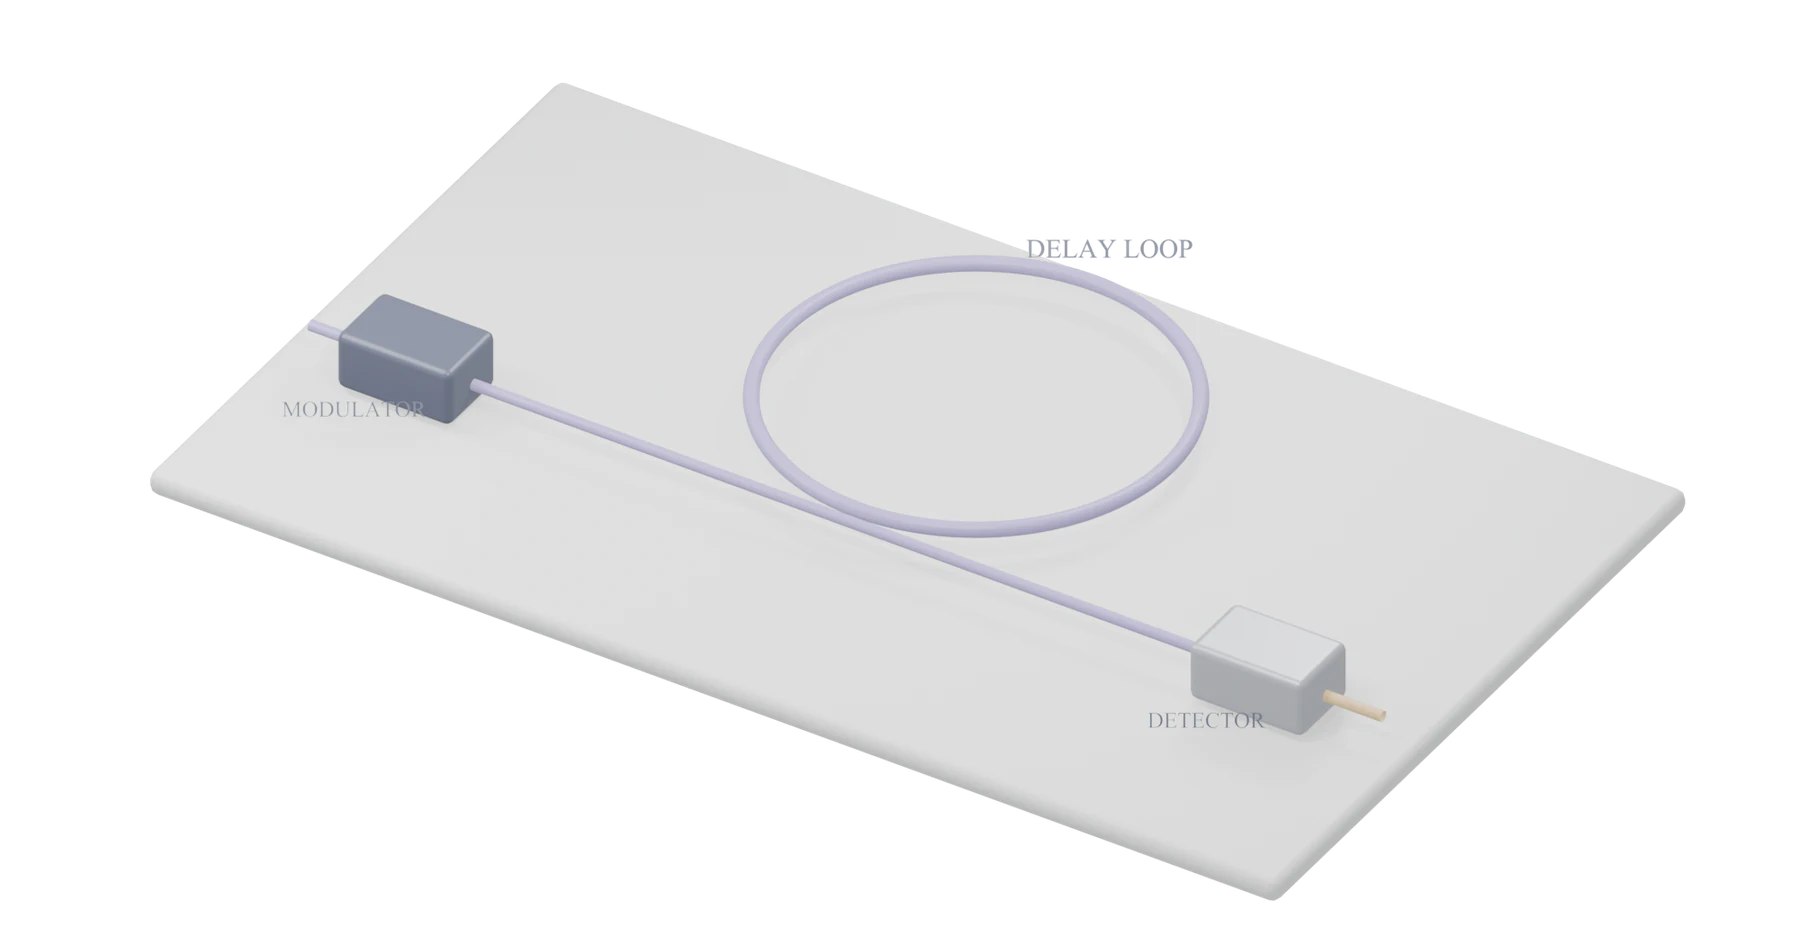
延迟回路型光学储备池的三维概念示意。调制器输入光信号,回路提供传播延迟,探测器读取输出;实际系统还需配置回路耦合、光源和电子读出。
脉冲神经网络通过事件和内部状态表示信息,器件的阈值、恢复和累积过程决定脉冲行为。相变材料等光子器件可用于构造特定的类突触或类神经元功能(Feldmann et al. 2019)。逐帧图像分类只有在系统中存在跨帧状态或后续时序融合时,才涉及相应的时间信息处理。光电混合网络则根据器件特性,将光学线性计算与电子非线性、控制和读出组合;各模块的接口与功耗应随任务一起评价(Ashtiani et al. 2022; Chen et al. 2023)。
储备池与脉冲网络的状态#
储备池计算通常固定内部连接或器件参数,通过训练读出层将状态映射为目标。输入信号驱动内部动态系统,历史输入以衰减、延迟或反馈的形式影响当前状态。所需的记忆跨度取决于任务:通信均衡需要保留一定时间窗口的信号,语音识别则需要汇聚较长时间的特征。读出层的采样速率和状态维度决定可利用的动态信息。
硅光子储备池可利用波导路径的延迟、相位和反馈形成具有历史依赖的光场;平方律探测再将场状态转换为非线性读出特征(Vandoorne et al. 2014)。这种分工使内部传播时间与读出形式共同决定可计算的时间关系:延迟改变不同时刻输入的重叠方式,探测得到的状态组合则供读出层学习。具有记忆的布尔逻辑与五位包头识别已通过实验研究,孤立语音数字识别在同一研究中通过仿真评估(Vandoorne et al. 2014)。
脉冲神经网络把输入表示为事件,并通过状态累积和阈值产生输出事件。一个简化的积分与发放模型可写成
其中 表示内部状态, 为衰减时间常数, 为驱动, 为比例系数, 为阈值。具体光子器件中的状态可以对应载流子、温度、材料相态或电压;各自的恢复时间和能量开销需要通过器件实验确定。
相变材料可以把突触的权重变化与神经元的状态积累连接到光脉冲传输中,形成具有学习能力的光子神经突触网络(Feldmann et al. 2019)。在这样的网络中,突触状态决定输入脉冲的作用强度,神经元的积累与阈值决定何时产生输出;材料状态的更新和恢复又影响后续事件。计算由此体现为事件时序与器件状态的共同演化。
波动动力学与循环计算的对应#
波动系统具有随时间变化的状态。设一个离散时间近似下的状态为 ,输入驱动为 ,在固定介质和边界条件下,其状态更新可抽象为 ;探测器从中形成可测输出。传播、反射、散射和损耗通过矩阵 的结构体现,输入耦合和传感位置对应矩阵 及读出算子。这样的表达让波动过程与循环网络之间形成可分析的联系(Hughes et al. 2019)。
这一状态表达可由二阶波动方程具体构造。对无损标量波场作空间离散,并用时间步长 进行中心差分,可得
这里 汇集波速分布、空间差分和边界条件, 表示离散驱动。当前场和前一时刻的场共同构成一阶状态,传播介质通过 影响相邻时刻的状态转移;稳定的数值计算还需根据空间网格与波速选择时间步长。若读出采用强度探测,测量中的模平方另行作用于线性波场,从而为输入到输出的整体映射引入非线性(Hughes et al. 2019)。
历史信息以波场的传播和叠加保留在系统中,其有效持续时间受损耗和边界反射影响。逆向设计可以调整介质参数,使时间信号经过散射后的状态更有利于目标读出。波动系统与循环网络的对应关系已用于数值研究原始音频波形的元音分类,该实例采用具有非线性响应的介质模型,并以探测位置的时间积分功率形成读出(Hughes et al. 2019)。探测位置和带宽决定哪些状态可以被读取,回路长度与衰减则影响输入历史在读出中所占的时间范围。
| 架构 | 主要处理过程 | 参数与非线性 | 评价关注点 |
|---|---|---|---|
| 衍射网络 | 空间调制与传播 | 相位或振幅调制;探测或层间激活 | 对准、孔径、光能利用 |
| MZI网络 | 波导模式相干混合 | 相位控制;激活由系统配置 | 损耗、漂移、校准 |
| 4系统 | 频域滤波与空间卷积 | 滤波器设置;层间处理可光电结合 | 采样、孔径、更新速率 |
| MRR/WDM | 波长通道加权与汇聚 | 谐振调节及探测 | 串扰、调谐功率、读出 |
| 储备池 | 动态状态与读出 | 器件动力学和读出权重 | 记忆时间、带宽、稳定性 |
典型光学计算架构的比较
器件选择与网络表达能力#
一个训练模型可实现的函数集合取决于输入编码、可调器件、传播结构和读出规则。对于固定波长的相干干涉网络,模型参数控制复场之间的线性映射;对相位型衍射网络,传播距离和空间调制共同约束可构造的映射;对功率加权网络,通道响应和差分读出决定可表达的实数系数。若网络包含动态状态,输入历史还成为当前输出的一部分。
比较表达能力时,首先要说明参数总数与每个参数的作用范围。一个衍射层像素会通过传播影响多个输出位置,多个输出之间的变化由同一物理参数共同控制。一个微环主要选择特定光谱范围,其调谐也会受到相邻通道的光谱响应影响。一个MZI单元控制参与混合的模式对,整个网格的自由度由单元数量和拓扑共同形成。设备结构与权重之间的映射由此具有明确的物理约束。
训练算法可以通过选择模型结构来适应这些约束。例如,卷积核共享可以利用4系统的频域形式(Fu et al. 2024; Hong et al. 2026);低秩分解可以把大矩阵表示为较小维度矩阵的乘积。对通道数量和相移范围受限的芯片,可以先在数字模型中加入对应的结构约束,再使用实测器件参数校准。模型精度、光学损耗和器件控制复杂度构成需要共同评价的结果(Zhou et al. 2022)。
发展历程与代表性研究#
可训练权重与光学变换的结合#
光学信息处理长期利用透镜、干涉仪和调制器完成信号变换。神经网络研究为这些器件提供了以数据和损失函数确定参数的方法,器件中的相位、耦合或透射量因而能够对应模型权重。2017年,Shen等(Shen et al. 2017)利用相干纳米光子电路展示可编程矩阵运算;2018年,Lin等(Lin et al. 2018)报告以数值训练设计衍射层的DNN。两种系统都利用线性光场变换,其数据路径、器件平台和可重构能力各有特点。
两项工作的共同变化是将器件设计纳入数据驱动的优化过程。给定输入样本与目标输出,损失函数衡量光学系统的输出偏差,优化算法再调整器件参数。可编程干涉电路把连续变化的相位写入芯片,实体衍射层则把训练得到的分布固化为材料厚度。前者便于重复配置,后者可以在固定光学结构中执行指定任务。参数写入方式由此成为比较后续研究的一条主线,也决定了设备面对新任务时需要怎样调整(Fu et al. 2024)。
物理节点与网络节点的对应关系也是这一阶段建立的认识。一个相移器通常调节局部场关系,完整权重矩阵由整个干涉网格共同形成;一个衍射像素则通过传播影响下一平面的多个位置。器件的局部可调参数与数学模型的独立权重具有各自的自由度。采用受物理结构约束的模型训练,可以把器件能够实现的变换直接纳入优化范围,使任务需求与光学结构在同一模型中对接。
可重构、集成与复用的并行发展#
后续研究扩展了器件与任务。可重构衍射处理器允许调整部分光学参数;片上衍射器件利用波导平台组织空间传播;多波长系统通过频谱通道开展并行加权(Zhou et al. 2021; Zhu et al. 2022; Fu et al. 2023; Xu et al. 2021)。这些工作分别改变参数写入、物理连接和数据通道,形成可以组合的技术方向。
可重构衍射处理器把空间调制器作为可反复写入的计算层,电子控制完成图样加载、探测结果处理和层间调度。一个器件可在时间上执行多个逻辑层,空间占用因此与逻辑网络深度分开设计。层复用的代价表现为多次曝光、调制和读写。评价这一类系统时,物理层数说明器件规模,逻辑层数说明任务映射,完整推理周期说明实现该映射所需的时间(Zhou et al. 2021; Zhang et al. 2026)。
片上衍射将传播结构移入波导平面,光场在受限几何区域内完成耦合与变换。该方向需要处理制备分辨率、波导边界和芯片接口的约束,可调器件则使制备后的结构获得校准与任务调整能力。2022年和2023年的片上衍射工作,以及2024年结合原位训练的多模态片上衍射系统,体现了器件制造、参数控制与学习方法逐步结合的过程(Zhu et al. 2022; Fu et al. 2023; Cheng et al. 2024)。
频谱复用开辟了另一种扩展方式。2021年的频率梳卷积加速器和集成光子张量核利用多个波长并行承载数据或运算通道,分别组织时间、波长和空间上的卷积运算(Xu et al. 2021; Feldmann et al. 2021)。此时,吞吐率来自多个通道和符号周期共同贡献;光源谱线、波长选择器和读出链路决定实际可利用的通道数量。空间规模、时间复用与频谱复用因此成为相互配合的设计变量(Zhang et al. 2026)。
| 年份 | 工作 | 系统与任务 | 技术特点 |
|---|---|---|---|
| 2017 | Shen等(Shen et al. 2017) | 相干集成电路;语音分类 | 可编程干涉变换 |
| 2018 | Lin等(Lin et al. 2018) | 衍射层;数字分类与成像 | 数值设计与太赫兹实体验证 |
| 2021 | Zhou等(Zhou et al. 2021) | 可重构衍射单元;图像与视频 | 光电复用与实验反馈训练 |
| 2021 | Xu等(Xu et al. 2021) | 微梳与延迟链路;卷积 | 波长和时间通道组合 |
| 2023 | Pai等(Pai et al. 2023) | 片上干涉网络;二维分类 | 光学梯度相关测量 |
| 2024 | Cheng等(Cheng et al. 2024) | 片上衍射;多模态分类 | 可调衍射单元和原位训练 |
| 2024 | Bandyopadhyay等(Bandyopadhyay et al. 2024) | 多层片上网络;元音分类 | 前向损失测量训练 |
代表性研究的器件、任务与技术特点
真实器件进入训练闭环#
离线训练通过光学模型求得参数,参数映射后由器件执行推理。制备差异、相位漂移和响应曲线误差会使实际变换偏离训练模型。将真实输出反馈给优化器,可以让更新方向适应当前器件状态。该方向的进展主要体现在梯度信息如何获取、误差信号在哪里处理,以及参数如何重新写入(Pai et al. 2023; Xue et al. 2024)。
真实器件参与训练后,梯度的获得成为连接光学传播与参数更新的关键。局部前向场和反向误差场的干涉可以提供相位梯度相关信息,从而让器件中的实际传播参与优化(Pai et al. 2023)。另一条路径利用空间对称与互易关系组织正向传播,以获得所需的误差信息(Xue et al. 2024);随机扰动方法则通过比较不同参数状态下的损失估计更新方向(Bandyopadhyay et al. 2024)。这几种方法的主要区别在于梯度信息如何形成,以及相应的信息需要经过哪些光学测量和电子处理。
随着隐藏层误差计算与神经元响应进一步集成到片上训练结构中(Ashtiani et al. 2026),训练闭环的设计也从单次传播扩展到层间信号、参数存储和控制的协同。各方法对器件对称性、测量次数与调节时间的要求,构成理解训练效率的共同线索;下一节从计算图出发讨论这些要求如何产生。
训练问题的计算图与硬件接口#
一套光学神经网络的训练过程可以从数据流和参数流两个方向理解。数据流从输入样本出发,经过编码、光场变换、探测和损失计算,最后得到描述当前任务表现的标量。参数流从训练算法出发,将更新后的相位、电压或透射率送到器件控制接口;器件达到新的状态后,下一轮数据流再采样该状态下的响应。训练形成一个围绕真实硬件或其数学模型的闭环。记录每条路径的载体、带宽和时间尺度,有助于理解实验系统的训练效率(Pai et al. 2023; Xue et al. 2024)。
设训练参数为 ,单个样本的模型输出为 ,损失为 。常用梯度更新写作
其中 表示更新轮次, 为步长,带帽符号表示实际获得的梯度或梯度估计。数字仿真根据模型计算导数;物理训练则让器件测量参与输出、误差信号或梯度的获得。两种方式都需要数据组织、优化器和参数配置,其成本构成随具体流程变化。
离线训练的核心条件是可计算的前向模型。自由空间传播模型可由衍射积分或角谱传播构造,波导网络模型可由耦合矩阵、相位响应和损耗参数组成。将模型输出与标签比较后,自动微分可以计算各器件参数对损失的影响。模型校准越充分,训练中的预测越接近器件表现;制造误差、环境漂移和输入输出接口的误差可通过参数测量、误差扰动训练与实验微调共同处理(Fu et al. 2024; Zhou et al. 2022)。
训练目标也影响实验表现。对于分类任务,交叉熵可推动正确类别获得较高相对分数;探测区收到的总光功率、各区间的差值和器件实际损耗则关系到测量稳定性。把分类损失与功率效率、参数范围或抗误差项结合,可以让优化过程兼顾任务分数和器件工作条件。各目标项的权重应随实验的光源功率、探测噪声和器件约束设置,形成与任务相对应的工程问题。
物理反向传播与局部梯度测量#
神经网络的反向传播使用链式法则,将输出误差逐层映射为参数导数。某一光学器件参数 的梯度依赖该位置的前向场、由损失构造的伴随场,以及器件对参数的局部响应。伴随方法利用传播算子的结构组织这些量,使梯度计算与波在器件中的传播联系起来。对于相位调节元件,局部前向场与伴随场之间的干涉项可以提供有关相位导数的信息(Pai et al. 2023)。
局部测量把器件的实际响应带入梯度,同时使更新质量依赖前向场和伴随场的相位关系。在已实现的硅光子训练系统中,光学传播与局部光功率测量承担梯度信息的获取,损失计算、层间激活和参数更新由电子系统配合完成(Pai et al. 2023)。测量噪声会扰动所得更新方向;在信号差较小时,提高采样次数可以改善估计,却会增加每轮训练的测量时间。梯度精度和训练速度因此通过同一套探测与控制链路相互联系。
前向模式与扰动估计#
梯度计算也可以借助光路的空间对称性与互易性,通过端口和坐标映射将所需传播组织在正向链路中(Xue et al. 2024)。其关键在于物理传播与计算图中转置运算之间的对应:端口映射和相位参考一旦变化,所构造的误差信息也会随之变化。实际输出参与测量后,训练能够反映一部分器件偏差;更新质量仍与光路满足这些对应关系的程度有关。
随机扰动训练采用另一种梯度信息来源。设随机方向为 、扰动幅度为 ,对同一参数向量执行正负两个方向的测量,可以构造方向差分
标量 反映损失沿所选方向的变化。通过适当的随机方向和估计规则,可据此形成参数更新;方向采样、扰动幅度和多次测量共同影响估计噪声。对实际硬件,还要等待扰动后的器件状态稳定,并为每次输入输出测量配置完整的数据路径。
随机方向法已经用于结合光学矩阵运算与光电非线性的片上深层网络(Bandyopadhyay et al. 2024)。它通过损失变化获取方向信息,因而使训练依赖多次参数设置和输出测量;采用传播对称关系的方案则依赖误差信号的构造和端口映射。两者将硬件复杂度分配到不同环节,随着参数规模、测量噪声和器件调节时间变化,达到同一任务精度所需的训练代价也会改变。
训练数据、校准和泛化#
光学硬件中的数据划分涉及多个独立步骤。器件标定使用已知输入或测试信号建立控制量与光学响应之间的关系;模型训练使用带标签样本优化任务参数;独立测试评估固定模型对新样本的输出。若系统具有额外的数字读出层,还需记录读出层的训练数据和输入来源。对多模态任务,模态之间的样本组成、标签和预处理方式也需要分别说明(Cheng et al. 2024)。
器件漂移会改变训练后的输入输出关系。测量可按时间记录参考信号、相位或输出功率,并将漂移过程与任务误差联系起来。若温度变化具有可观测的慢时间尺度,可在推理间隔插入校准;若变化较快,则需要更频繁的反馈或对漂移具有适应性的训练。两种情形对额外测量次数和控制功率的要求各有特点。
泛化评价可包括新样本、新工作条件和新器件三个层次。新样本测试考察同一器件对输入分布的处理;改变照明功率、温度或对准条件可检验系统对环境变化的适应;在多个制造芯片上复用模型则涉及器件间差异。报告时分别列出数据集划分、器件数量和环境范围,有助于判断所得结论对应的应用条件。
典型应用领域#
图像分类与机器视觉#
图像中的空间分布可以直接映射到光场,使传播过程参与特征形成。衍射网络可将输入图案映射为输出区域的光强分布,以区域响应完成分类(Lin et al. 2018);光电混合结构则进一步把光学变换与电子信号处理连接,形成适用于动态视觉任务的数据路径(Chen et al. 2023)。两类系统的共同问题是如何在压缩输入的同时保留任务所需信息,以及如何把所得特征传给后续决策环节。
ACCEL分别采用单层全模拟光电计算,以及连接数字神经网络后的配置。其时序实验根据连续三帧判断车辆运动方向,模拟光电前端的输出经过二值化后存入数字存储器,再由单层数字网络生成最终判断(Chen et al. 2023)。前端特征提取、跨帧存储和分类因而对应数据路径中的不同环节。
图17比较了两种配置:单层模拟光电网络在MNIST、Fashion-MNIST和KMNIST上的准确率分别为90.9%、80.9%和67.6%,连接数字网络后的相应结果为97.1%、85.5%和74.6%(Chen et al. 2023)。这组结果呈现了前端特征与后续数字判决配合时的任务表现,也说明输出特征的使用方式会影响最终分类结果。
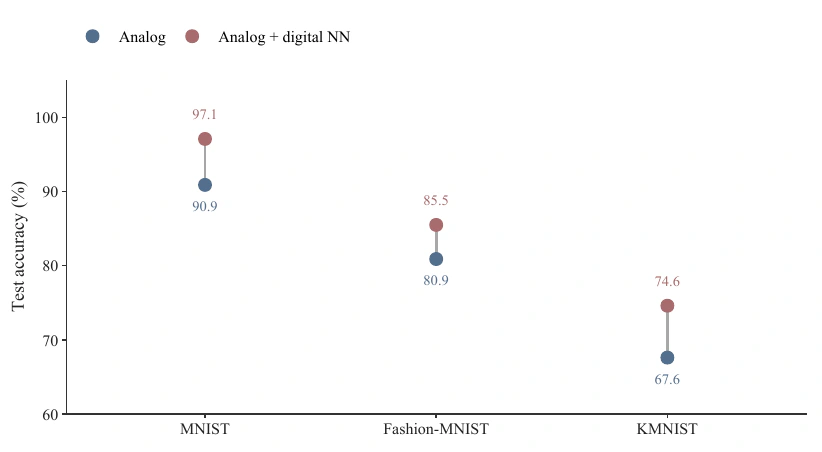
ACCEL在三种数据集上的实验分类准确率。蓝色为经自适应训练的全模拟配置,红色为连接小规模数字神经网络后的配置;连线表示同一数据集对应的两种处理配置。数据依据Chen等(Chen et al. 2023)的原文和图4d、e绘制。
视觉前端的信息压缩与任务需求#
视觉系统的输出形式决定光学前端应保留哪些信息。分类任务可以把输入压缩为少量类别得分;定位和分割还依赖目标的位置与区域边界;视频识别则需要跨时刻关联。检测通道越少,后续系统能够访问的空间信息越受约束。因此,光学前端的设计需要同时确定目标任务、输出通道布局和压缩后的特征可分性。
对于衍射分类,探测区域的面积和位置共同决定信号收集与类别分离。区域扩大有利于收集更多能量,但在有限输出面内,多类别区域需要共享空间;相邻区域的响应重叠又会影响类别间的判决裕度。输出平面上的类别区域和接收能量共同构成分类判决的基础(Lin et al. 2018)。训练时若同时考虑目标区域的能量和其他区域的响应,就可以把分类目标与光能分配联系起来。设两类检测信号的均值差为 、噪声标准差为 ,则 可用于分析局部判决裕度;完整分类结果仍取决于各类别的信号分布和决策规则。
输入来源进一步决定前端的系统意义。数字图像需要先经调制器加载,空间光场则可以通过成像光路直接进入处理结构;前者的速度受数据编码和加载过程影响,后者的特征形成与照明、成像及光学对准相联系(Lin et al. 2018; Chen et al. 2023)。当网络还需组合多帧信息时,空间特征必须跨越帧间间隔加以保存或汇聚。模拟光电前端结合数字存储与分类层的结构,体现了高速特征形成与时间信息组织之间的协作(Chen et al. 2023)。
衍射分类中的任务映射与器件适配#
衍射分类的核心是将类别判决编码为空间能量分布。输入图案经过多层传播后,不同类别在输出面形成各自的能量分布;若为每类配置一个检测区域,区域间的相对信号便构成决策依据。五层衍射分类器的数值测试在一万个MNIST样本上获得91.75%准确率;相应的太赫兹实体演示测量了50个打印图案,这些图案从数值分类成功的样本中选取(Lin et al. 2018)。两组结果分别呈现模型的测试表现与实体器件对选定输入的光场响应,由此可以把分类规则和物理验证联系起来。
当训练模型与实际光路存在偏差时,增加衍射层也会使早期误差影响后续传播。可重构光电衍射处理器通过逐层测量实际输出,再调整后续参数,将器件响应引入训练过程;其三层手写数字分类实验中,直接加载预训练参数与自适应训练后的盲测准确率分别为63.9%和96.0%(Zhou et al. 2021)。这一变化体现了层间误差与参数调整之间的联系:训练的有效对象从理想传播模型延伸到实际可调用的光学模块。
相同模块还可通过时间复用处理视频序列。每次光学调用形成当前输入的空间特征,循环连接则将先前时刻的信息带入后续计算(Zhou et al. 2021)。因此,静态分类和动作识别的差别体现在信息如何跨越时间,而可重构波前与电子状态存储共同决定了同一物理模块能够承担的网络结构。
光通信与高速信号处理#
光通信接收链路需要处理传输过程中产生的噪声、色散和非线性失真。神经网络能够根据接收信号及其时间上下文估计失真,光电混合电路则为其中的加权运算与神经元响应提供实现途径(Huang et al. 2021)。将这一映射嵌入接收机时,信号时序和器件调用方式共同决定处理流程。
通信补偿中的时间窗口与硬件复用#
光纤信号的当前符号会受到相邻符号及传播历史的影响。将一段接收样本组织为网络输入,可以让补偿器利用这些时间关联估计失真;窗口扩展提供了更长的上下文,同时增加输入维度和加权计算量。光子电路的作用由此与接收机的数据调度相连:网络处理的窗口需要按顺序进入权重阵列,计算结果还要与目标符号在时间上对齐。
在一项以10080 km传输链路为背景的非线性补偿研究中,训练后的参数分为四组,每组配置一个 权重矩阵和两个神经元偏置;硬件实验将对应的两路信号以46.875 MBaud回放,依次调用同一光电电路(Huang et al. 2021)。这种组织使小规模电路能够参与较大网络的计算:微环权重库完成信号加权,探测和调制形成神经元响应,分组配置则在时间上复用硬件。网络映射的完整处理节奏因此受到参数切换、信号回放及各次计算结果汇集方式的共同约束。
对通信应用而言,增加光学通道和扩大时间复用具有不同后果。前者倾向于增加并行器件与接口,后者需要缓存数据并延长完成一次网络运算的时间。接收链路能否持续处理目标符号流,取决于窗口长度、复用次数与前后级速率之间的匹配。因而,误码表现说明补偿映射的任务效果,持续处理速率则进一步反映这一映射如何落实到数据路径中。
动态与多模态感知#
动态感知可以由光学系统逐帧提取空间特征,再由具有状态的模块整合时间信息;也可以使用光学储备池直接处理序列。前者依靠跨帧存储连接不同时刻的特征,后者利用物理状态的衰减和反馈保留输入历史(Duport et al. 2012; Vandoorne et al. 2014)。
储备池中的记忆可由反馈路径、延迟和器件响应形成。任务所需的时间尺度与物理状态的衰减速度相匹配时,读出层才能利用与当前判断相关的历史信息。
感知系统还面临输入类型变化的问题。不同传感器获得的数据可以先转换为统一维度的特征,再由可重构光学网络执行任务相关的映射。例如,一种片上衍射网络分别处理视觉、声音和触觉的四分类任务,在各含100个样本的测试集中得到86%、82%和89%的准确率(Cheng et al. 2024)。统一的光学接口使同一器件能够适配不同的数据表示,而特征构造方式仍与传感模态密切相关。
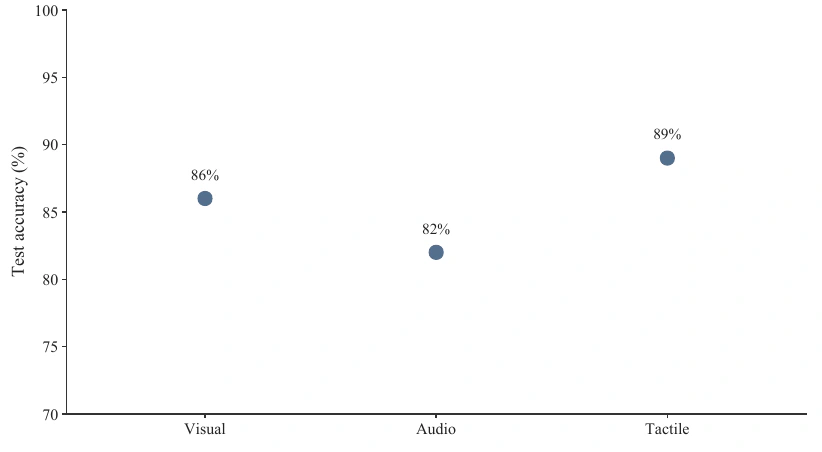
可调片上衍射网络对视觉、音频和触觉数据的实验分类准确率。每种模态的测试集各包含100个样本;数据依据Cheng等(Cheng et al. 2024)的原文和图5m–o绘制。
序列任务中的物理记忆#
对序列任务,当前输出取决于输入历史如何进入系统状态。若将输入记为 、内部状态记为 ,读出层便从状态轨迹中形成对目标的估计。储备池利用器件本身的传播、延迟和衰减生成状态,再训练读出层将这些状态映射到任务输出(Duport et al. 2012; Vandoorne et al. 2014)。物理记忆的时间尺度由此与任务所需的上下文长度直接相连。
时间延迟结构可以在一个回路周期内取多个采样位置,形成一组虚拟节点。增大采样位置数量能够改变状态表示的维度,而相邻位置之间的相关性仍由器件响应和采样间隔决定;若状态变化过慢,相邻采样值趋于相近,新增坐标提供的信息也会减少。片上波导网络则通过不同传播路径、干涉和探测形成状态响应。硅光子储备池的实验包括具有记忆的布尔逻辑和五位包头识别,语音数字识别在数值模型中研究(Vandoorne et al. 2014)。这类任务把状态需要保留多久、读出端如何区分不同输入历史,转化为可以共同设计的参数。
对于事件驱动的脉冲网络,时间信息还可以由脉冲间隔和器件恢复过程表达。相变材料突触的状态改变了后续脉冲的传输,神经元响应再将累积输入转换为事件输出(Feldmann et al. 2019)。与固定时间窗口上的向量运算相比,这类系统的有效计算与事件到达时刻相联系;器件状态更新、恢复时间和输入事件的统计结构共同影响可形成的时序关系。
异构感知信号与共享光学映射#
视觉、声音和触觉数据具有不同的采样结构:图像的邻域关系存在于空间,声音的主要结构沿时间展开,触觉信号则取决于传感器的布置及其响应。将这些数据交给同一光学网络,关键在于构造适合共同输入端口的特征,同时保留各自与任务有关的信息。输入端口数限制一次可加载的特征维度;当特征需要分批输入时,光路复用又会引入额外的数据组织与读出过程。因此,器件可重构性和特征表示能力共同决定多种任务能否共享计算硬件。
可调片上衍射网络提供了一个具体例子:手写图像经裁剪及电子网络压缩,声音经频谱分析提取特征,随后分别编码为16路光强;片上五层可调结构将输入映射到四个检测端口(Cheng et al. 2024)。这些预处理方法为同一物理网络构造了不同的特征表示。光场传播负责特征之间的耦合,可调相位改变耦合后的能量分布,四个输出端口的相对响应则对应分类结果。图像压缩和频谱提取决定了哪些信息可以进入这一映射,器件训练则调整已输入特征与类别之间的关系。
图18展示了三类数据分别进行四分类时的测量结果。每类数据采用相同数量的测试样本,而输入特征及其提取方式不同;准确率的变化因此反映了数据表示、器件配置和分类任务的共同作用。若进一步将多种传感信息用于同一次判决,还需要建立样本间的时间或事件对应关系,再设计特征在输入端或读出端的组合方式。这样,问题便从共享硬件上的单模态分类延伸到跨模态信息如何互补,以及融合环节所需的接口和状态存储。
专用光子加速#
专用光子加速器将网络中反复出现的运算映射到可复用的光学结构。卷积尤其适合用来讨论这种映射:同一组权重依次作用于许多局部窗口,而不同输出通道又可以共享输入。如何在物理器件中组织这两种复用,决定了光学并行性与完整任务之间的联系。
卷积映射与并行资源的组织#
卷积的共同运算是把局部输入窗口与权重逐项相乘,再沿窗口维度求和。令窗口展开为 ,第 个卷积核展开为 ,则位置 的输出为 。这一形式把硬件设计归结为三个相互关联的问题:如何同时提供窗口中的 个数据,如何保持或改变权重,以及如何把各乘积汇聚到同一个输出。不同光子架构对时间、波长和空间的分配方式,决定了这些步骤的实现及复用关系。
一种安排是让同一输入序列复制到多个波长,利用相邻通道的延迟形成不同时间位置的窗口;另一种安排是将权重保存在波导阵列中,把窗口向量送入对应的空间端口,再通过波长通道并行处理多个向量(Xu et al. 2021; Feldmann et al. 2021)。前者将窗口构造与传播延迟结合,后者将矩阵系数保存在局部材料状态中。两种映射均可使用波分复用,但波长所承载的数据关系不同:在延迟卷积中,不同波长对应窗口内的加权项;在张量核的并行矩阵运算中,波长复用还用于让多个输入向量共享同一组权重。
这种区别直接影响扩展方式。增加卷积核或窗口长度,会改变延迟方案所需的谱线、权重和探测通道;扩大矩阵核则会增加阵列中的存储单元、波导连接及输入输出资源。对连续处理同一任务的场景,权重可以在多次输入之间复用;当任务发生变化,重新配置所需时间将与有效计算时间共同决定实际处理速率。以下结合两种物理映射讨论这些关系。
延迟卷积:从时间序列到二维窗口#
微梳产生的一组谱线经过光谱整形后承载卷积权重,同一输入序列经调制复制到这些通道。色散链路使相邻通道之间形成逐级延迟;当延迟步长与采样周期一致时,同一探测时刻汇聚的光功率就对应输入序列中相邻位置的加权和。将不同卷积核分配给不同谱线组,并分别探测,便能对同一序列并行生成多路输出(Xu et al. 2021)。
这种映射的计算速度与数据排列紧密相连。以 图像的实验为例,十个 卷积核对应九十条谱线,图像先被展平为62.9 GBaud的序列。按一次乘加计作两次运算,九十个加权通道给出约11.3 TOPS的向量运算率;实验中二维卷积沿纵向采用步幅3,相应的有效矩阵运算率约为3.8 TOPS(Xu et al. 2021)。两者之间的差别来自一维时间序列与二维窗口之间的映射:器件按时隙持续产生加权结果,图像任务所需的有效窗口则由展平顺序和步幅决定。
进一步构造分类网络时,卷积输出还需要经过非线性和池化,再形成后续层的输入。同一微梳加速器也可配置为向量内积单元,分阶段执行卷积与全连接计算(Xu et al. 2021)。这一复用方式将硬件规模与模型规模部分解耦,但各阶段之间的数据转换、缓存和参数切换会影响整网处理节奏。因而,器件级并行度与网络级吞吐之间的联系,取决于卷积输出能否以所需格式和速率送入下一层。
权重保持与网络状态的时间尺度#
当多个输入窗口使用同一卷积核时,权重在窗口之间保持稳定可以减少重复配置。相变材料张量核利用材料状态改变波导透射,将矩阵系数保存在阵列局部;输入向量经过分路、加权和探测后形成矩阵运算结果。波分复用使多个输入向量能够经过同一物理权重阵列,从而把权重保持与数据并行结合起来(Feldmann et al. 2021)。这种结构适合权重更新相对于输入到达缓慢的工作模式:材料写入发生在模型配置阶段,连续读出则服务于随时间变化的数据。
可调微环提供了另一种权重组织方式。微环的谐振位置决定不同波长的传输响应,调节谐振条件便可改变通道权重。在广播与加权网络中,各波长信号经权重库和探测器形成电信号,电光模块依据该信号生成新的输出;反馈连接使当前状态参与后续演化(Tait et al. 2017)。因此,同样的加权求和既可以服务于静态卷积,也可以成为循环动力学中的耦合项;后一情形的输出还取决于器件带宽、反馈时延与输入历史。
由此可将权重技术放在网络的时间结构中理解:权重的保持或调节决定模型如何配置,调制与探测速度决定输入如何流过网络,反馈和状态衰减则决定历史信息保留多久。选择器件时,需要使这几种时间尺度与任务匹配,才能将器件的并行计算能力转化为持续的系统处理能力。
性能限制与评价方法#
损耗、噪声与精度#
光学矩阵运算的输出受输入光源、器件和探测链路共同影响。波导传播、耦合器以及调制器引入的损耗减少探测器接收到的光功率;在其他条件相同时,光功率降低会改变信噪比。探测噪声包括与光子统计有关的散粒噪声以及电子读出噪声,实际贡献取决于探测带宽、积分时间、光功率和电路设计。提高光功率可改变探测信噪比,光源电功率与散热开销也随系统配置变化(Farmakidis et al. 2024; Zhang et al. 2026)。
参数误差会改变实现的变换矩阵。例如干涉臂相位漂移会改变输出端的功率分配,微环谐振频率漂移会影响波长通道权重。对于多个器件级联的系统,误差在传播过程中积累,其影响与网络拓扑、输入分布和训练方式有关。精度应在明确输入范围与输出读出方式的条件下测量,器件控制位数与网络有效计算位数各有相应的测量定义。
将硬件测量引入训练或校准,有助于减少模型与器件之间的偏差。该方法涉及测量次数、稳定时间和参数更新电路;网络扩大后,校准成本也应纳入评价。温度变化和长期运行条件下的稳定性可以通过重复测量、漂移曲线与任务准确率共同表征(Pai et al. 2023; Bandyopadhyay et al. 2024)。
系统边界、延迟与能耗#
一次完整推理包含输入数据准备、光信号生成或调制、光学计算、探测及输出处理。光在计算核心中的传播时间只是其中的一部分;调制器响应、探测积分、数据转换和电子控制也可能决定系统延迟。吞吐率描述单位时间完成的任务数量,与单个输入的端到端延迟含义不同。流水线可以提高吞吐率,但其批处理方式与启动延迟需要单独说明。
系统功率可按功能模块近似分解为
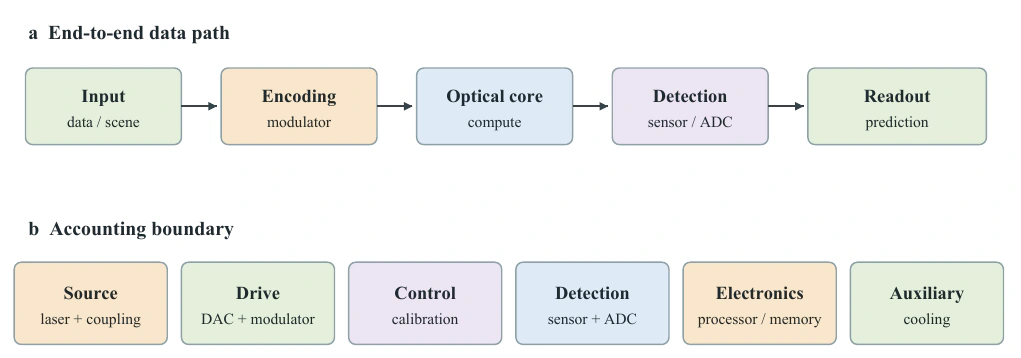
光学神经网络端到端系统的数据路径与功率统计边界。光源、调制、计算、探测、电子处理以及控制和辅助模块共同决定系统的运行开销。
各项分别代表光源、输入调制、控制、探测、电子处理及辅助设备的功率。各论文的测量边界可能只覆盖其中部分模块,因此系统间比较需要先检查哪些部分被计入。将运算次数除以能量得到的能效也依赖运算定义:一次乘加是否计为两次运算、是否计算填充和重复数据、报告值是峰值还是持续值,都会影响结果(Zhou et al. 2022; Zhang et al. 2026)。
能效比较还需要相同任务、可比精度和一致的数据输入输出条件。若某光学系统以图像直接照明为输入,而电子系统必须先读取数字文件,两个系统的数据路径不同;比较时应记录任务入口及探测输出的位置。统一边界后,才能判断光学算子节省的运算开销与接口开销之间的关系。
可扩展性与训练成本#
扩展网络可以增加空间通道、波长通道、时间复用或层数。空间规模增加会带来更多器件和连接;波长复用要求控制通道间隔和滤波串扰;时间复用会改变等待时间和数据缓存需求。多个自由度可以组合使用,但可用通道总数还受损耗、噪声、控制带宽和器件面积约束(Bai et al. 2023; Zhang et al. 2026)。
训练成本包括每轮需要的前向测量、梯度估计、参数更新与校准。物理反向传播利用光学系统获取梯度相关信息,前向模式训练则通过正向过程构造更新所需的信息;这些方法的硬件条件和测量成本需要结合各自实验确定(Pai et al. 2023; Xue et al. 2024; Bandyopadhyay et al. 2024)。固定参数推理和完整训练对应各自的能耗统计范围。
光子预算、动态范围与误差传播#
一个光学计算系统的光子预算描述光源发出的能量如何分配到输入通道、传播路径和探测器。设输入平面上的平均光功率为 ,从输入到指定探测器的总功率透射率为 ,探测积分时间为 ,工作频率为 ,则在窄带近似下,到达探测器的平均光子数为
其中 为普朗克常数。这个表达式将光功率、器件损耗和时间分辨率联系起来;每个输出通道通常对应自己的 和积分区间。多通道系统还需说明总光功率在通道间的分配,才能从单通道光子数推算整个系统的光源要求。
在理想泊松光子统计的近似下,光子计数的标准差随平均计数的平方根变化。当有效量子效率为 时,可探测事件的平均数约为 ,相应的理想计数信噪比约为 。由此可见,在其他条件固定时,信噪比提高一倍需要四倍的平均探测光子数;若积分时间缩短为原来的一半,维持相同光子数需要两倍的探测功率。实际读出还包括暗电流、热噪声、放大器噪声和量化误差,主导噪声随工作点变化(Farmakidis et al. 2024; Zhang et al. 2026)。
光源相对强度噪声会使各通道共享一部分功率波动;相位噪声则通过干涉项影响相干计算。共享噪声的影响取决于编码和读出方式:差分探测利用两路变化的相关性抵消共同分量,两路光功率和电路响应失配时,残余波动会进入差分结果。相位参考发生漂移时,原先设定的干涉工作点随之移动,矩阵权重与探测信号也会改变。
动态范围描述系统可区分的信号范围。低功率端受到噪声影响,高功率端受到探测器、电路线性区间或器件热效应约束。对于具有大、小奇异值的矩阵,较小输出分量可能落在读出动态范围的低端。训练时可通过输入归一化、输出缩放、差分编码或约束矩阵条件数改善信号分配;具体方案应与任务允许的数值范围和器件功耗一起评价。
在分层网络中,光学误差沿后续计算路径传播。若第 层的实现矩阵为 ,小扰动首先形成与 和该层输入有关的偏差,再经过后续线性变换及激活函数的局部响应。因而,相同幅度的器件误差在不同层和不同输入下可能产生不同影响;对接近判决边界的样本,即使较小的输出变化也可能改变类别。器件精度与任务精度之间由此形成依赖网络参数和输入分布的联系。
光路、器件与任务三个层次的稳定性#
自由空间衍射系统的稳定性受到光源波长、入射角、层间距离和横向对准影响。各层之间的相对位移改变传播矩阵,输出探测区域的位置也影响类别信号的积分。实验可以扫描横向偏移、倾角和传播距离,记录光强分布及分类准确率,并给出满足目标性能的容差区间。容差曲线把光学装调精度与任务要求联系起来,也可用于训练阶段的扰动采样(Lin et al. 2018; Hu et al. 2024)。
集成干涉系统的相位稳定性由温度、驱动和材料响应共同决定。单个热光相移器改变温度时,邻近器件也可能发生相位变化;测量控制矩阵可以表征这种耦合。控制矩阵的对角元素对应本通道响应,其余元素描述控制信号对其他通道的影响。较高维网络需要在标定周期、响应速度和控制通道数量之间建立统一的评价方式(Shen et al. 2017; Farmakidis et al. 2024)。
微环网络的稳定性可通过谐振频率、线宽、通道间距及探测端功率评估。温度漂移会移动谐振位置,从而改变波长加权结果。对于多个相邻信道,校准数据可包含每个控制状态下的完整透射谱;将测得的光谱响应输入训练模型,可以让权重选择与实际通道串扰相匹配。多波长光源的功率平坦度也会改变各通道的可用信噪比,需要与权重范围共同记录(Tait et al. 2017; Bai et al. 2023)。
任务级稳定性关注器件变化最终造成的输出变化。对分类器,可以报告各类别混淆矩阵随温度和时间的变化;对通信处理,可以记录误码率或 因子随输入功率和传输条件的变化。系统测量还应保存校准前后所使用的样本与参数设置,使改进效果能够对应明确的数据路径。
延迟、吞吐与运算计数#
端到端推理延迟从样本进入系统计时,到任务输出可供使用时结束。在一个依次处理的单样本流程中,可以把数据加载、编码、光传播、探测、转换与后处理所需时间按实际先后关系相加。流水线系统中,多个样本可能同时处于不同阶段,因此稳态吞吐由各阶段的调度和瓶颈共同决定。对同一设备,单样本等待时间和每秒处理量描述了两个互补指标。
矩阵乘法的运算计数需要明确矩阵维度与计数规则。若一个 的稠密实矩阵作用于一个 维向量,直接展开含有 次乘法和 次加法。把一次乘加近似计为两次基本运算,可以得到约 次操作的常见统计形式;实际边界还涉及偏置、激活、数据搬运和精度处理。复数运算的计数规则与实数运算需要分别说明,卷积中的零填充和重复窗口也会影响有效操作数(Zhou et al. 2022; Xu et al. 2021)。
在稳态工作区间,若整机平均电功率为 ,有效任务完成率为 ,单样本平均能量可写为 。这个关系要求功率和吞吐在相同运行区间测得。待机功率、设备启动、权重写入和校准可按所研究任务的使用方式分摊;例如长期固定权重的推理与频繁切换任务会形成不同的每样本成本。
能效统计可分别给出光学计算、芯片、模组和整机等边界。光学计算边界可以用于研究传播与探测所需的能量;芯片统计可包含片上控制、热调节和驱动;模组可进一步包含激光、封装和接口;整机统计则覆盖外部计算和辅助设备。探测器、驱动器与光源的位置由具体系统决定,比较时需要列明各边界实际包含的器件。依照应用入口记录这些设备及其能耗,可以识别主要成本来源(Shastri et al. 2021; Zhang et al. 2026)。
规模扩展与任务映射#
扩展一个光子网络时,物理通道数、逻辑网络维度和可训练参数数目由器件拓扑与复用方式共同决定。空间上增加波导或像素可以并行处理更多模式;时间复用让同一器件按顺序处理多个子问题;波长复用让多个信道在共用光路中传播(Zhang et al. 2026; Bai et al. 2023)。空间展开主要增加器件与连接,时间复用增加调度和缓存,波长展开则占用光源带宽并引入频谱选择需求。三者组合时,共享的光功率与探测资源将这些扩展方式联系起来。
稠密矩阵与结构化矩阵在硬件规模上具有不同需求。若任务允许使用卷积、低秩或稀疏结构,算法可以减少独立权重并改变数据路径;模型精度、训练方法和硬件开销应共同评价。对时间复用网络,逻辑层数随模块调用次数增加,同时还要记录每次重新加载的延迟。对波长复用系统,通道数与光源带宽、滤波线宽、串扰以及探测器带宽相关。
训练规模与推理规模也存在各自的资源需求。训练可能需要保存中间状态、计算损失、生成扰动或测量局部场;推理则更多关注固定参数下的输入输出速率。把训练阶段的设备和推理阶段的设备分别列入系统表,可以使功率、时间和器件面积的统计更清楚。最终比较应围绕实际任务给出准确率、模型规模、持续吞吐及完整边界,从而得到可解释的工程结果。
| 评价项 | 建议记录的内容 | 对解释的作用 |
|---|---|---|
| 任务与数据 | 输入来源、样本量、训练测试划分 | 对应模型用途与结果范围 |
| 精度与稳定性 | 误差指标、重复测量、温度与时间 | 描述任务表现及环境影响 |
| 时间 | 数据加载、处理、读出及调度方式 | 对应延迟和持续吞吐 |
| 功率 | 光源、控制、探测、电子与辅助设备 | 确定能量统计边界 |
| 运算口径 | 矩阵规模、乘加计数、有效输出 | 支持吞吐与能效比较 |
系统级性能评价的记录项目
未来发展方向#
面向可级联计算的器件与接口#
多层网络的性能取决于相邻层之间能否持续传递可区分的信号。线性光学结构形成加权变换后,激活和再编码环节需要提供适合下一层的信号范围;分光、传播损耗及探测噪声则逐层改变信号质量。激活器件的传输曲线、响应速度和工作功率应与前后级共同设计,从而在非线性强度、带宽与功率预算之间建立可实现的工作点(Destras et al. 2023; Zhang et al. 2025)。
可级联性还与扇出有关。一个节点驱动多个后续通道时,可用光功率会随分配方式变化;若引入光电再生,新的光载波能够重新设置信号幅度,探测、调制与光源则形成额外的能量路径。对于固定参数推理,长期稳定的权重可减少配置频率;在线学习则要求参数更新与数据流并行协调。光学核、信号再生和控制系统因此需要围绕同一任务的速率与精度要求联合设计。
面向器件变化的训练#
硬件训练的价值来自对实际器件响应的利用,而训练收益取决于测量和更新是否跟得上器件变化。伴随场测量、利用传播对称性的前向方法和随机扰动方法分别通过局部场、端口映射及损失变化获得更新信息(Pai et al. 2023; Xue et al. 2024; Bandyopadhyay et al. 2024)。当相位漂移主要发生在较慢时间尺度上,间隔校准可以在多次推理之间维持工作点;漂移接近数据处理时间尺度时,网络需要更快的反馈或对变化具有适应性的参数表示。
训练策略还应与参数规模相匹配。局部场测量可能增加探测和信号组织的复杂度;随机扰动减少了对内部场的直接访问,却需要通过多次测量积累更新信息。比较训练方法时,梯度估计质量、达到目标误差所需的更新次数与每次更新的物理测量时间应结合起来。这样才能理解器件误差的补偿收益如何转化为可持续运行的系统性能。
多自由度复用与任务结构#
空间、波长、时间和偏振复用为同一任务提供了多种映射方式。将运算展开到更多空间或波长通道,可以增加同时处理的信号数量;相应的光源功率、滤波、读出与串扰控制也随通道组织改变。时间复用能够让一组器件执行多个步骤,其收益则依赖缓冲、参数切换和输出汇聚的速度(Bai et al. 2023; Zhang et al. 2026)。因此,可扩展性来自任务结构与物理资源之间的匹配,而需要同时考虑可用通道、误差和接口带宽。
卷积权重共享、稀疏连接和低秩分解为这种匹配提供了具体入口:前者使一组参数能够重复作用于多个窗口,后两者能够改变所需连接数或矩阵规模。硬件的调节范围、损耗和测量误差也可以进入模型优化,使训练得到的算子适应可实现的物理结构。对于视觉和通信等任务,输入已经具有空间或时间结构,选择与之相符的光学表示有助于减少中间数据变换,并让光学并行性服务于完整的数据路径。
结论#
光学神经网络通过干涉、衍射、频域变换和动力学过程组织信号计算;输入编码、可调参数、探测与控制共同定义其实际映射。不同架构的价值取决于任务是否能够有效利用其空间传播、波长并行或物理状态,以及这些能力与电子接口、训练和信号再生如何衔接。围绕任务精度、数据流与系统资源展开协同设计,是连接器件性能和应用能力的关键。
参考文献#
Ashtiani, Farshid, Alexander J. Geers, and Firooz Aflatouni. 2022. “An on-Chip Photonic Deep Neural Network for Image Classification.” Nature 606 (7914): 501–6. https://doi.org/10.1038/s41586-022-04714-0 ↗.
Ashtiani, Farshid, Mohamad Hossein Idjadi, and Kwangwoong Kim. 2026. “Integrated Photonic Neural Network with on-Chip Backpropagation Training.” Nature 651 (8107): 927–32. https://doi.org/10.1038/s41586-026-10262-8 ↗.
Bai, Yunping, Xingyuan Xu, Mengxi Tan, et al. 2023. “Photonic Multiplexing Techniques for Neuromorphic Computing.” Nanophotonics 12 (5): 795–817. https://doi.org/10.1515/nanoph-2022-0485 ↗.
Bandyopadhyay, Saumil, Alexander Sludds, Stefan Krastanov, et al. 2024. “Single-Chip Photonic Deep Neural Network with Forward-Only Training.” Nature Photonics 18 (12): 1335–43. https://doi.org/10.1038/s41566-024-01567-z ↗.
Chen, Chenduan, Zhan Yang, Tao Wang, et al. 2024. “Ultra-Broadband All-Optical Nonlinear Activation Function Enabled by MoTe2/Optical Waveguide Integrated Devices.” Nature Communications 15 (1): 9047. https://doi.org/10.1038/s41467-024-53371-6 ↗.
Chen, Yitong, Maimaiti Nazhamaiti, Han Xu, et al. 2023. “All-Analog Photoelectronic Chip for High-Speed Vision Tasks.” Nature 623 (7985): 48–57. https://doi.org/10.1038/s41586-023-06558-8 ↗.
Cheng, Junwei, Chaoran Huang, Jialong Zhang, et al. 2024. “Multimodal Deep Learning Using on-Chip Diffractive Optics with in Situ Training Capability.” Nature Communications 15 (1): 6189. https://doi.org/10.1038/s41467-024-50677-3 ↗.
Clements, William R., Peter C. Humphreys, Benjamin J. Metcalf, W. Steven Kolthammer, and Ian A. Walmsley. 2016. “Optimal Design for Universal Multiport Interferometers.” Optica 3 (12): 1460–65. https://doi.org/10.1364/OPTICA.3.001460 ↗.
Destras, Oceane, Sébastien Le Beux, Felipe Gohring De Magalhães, and Gabriela Nicolescu. 2023. “Survey on Activation Functions for Optical Neural Networks.” ACM Computing Surveys 56 (2): 35:1–30. https://doi.org/10.1145/3607533 ↗.
Duan, Zhengyang, Hang Chen, and Xing Lin. 2023. “Optical Multi-Task Learning Using Multi-Wavelength Diffractive Deep Neural Networks.” Nanophotonics 12 (5): 893–903. https://doi.org/10.1515/nanoph-2022-0615 ↗.
Duport, François, Bendix Schneider, Anteo Smerieri, Marc Haelterman, and Serge Massar. 2012. “All-Optical Reservoir Computing.” Optics Express 20 (20): 22783–95. https://doi.org/10.1364/OE.20.022783 ↗.
Farmakidis, Nikolaos, Bowei Dong, and Harish Bhaskaran. 2024. “Integrated Photonic Neuromorphic Computing: Opportunities and Challenges.” Nature Reviews Electrical Engineering 1 (6): 358–73. https://doi.org/10.1038/s44287-024-00050-9 ↗.
Feldmann, J., N. Youngblood, M. Karpov, et al. 2021. “Parallel Convolutional Processing Using an Integrated Photonic Tensor Core.” Nature 589 (7840): 52–58. https://doi.org/10.1038/s41586-020-03070-1 ↗.
Feldmann, J., N. Youngblood, C. D. Wright, H. Bhaskaran, and W. H. P. Pernice. 2019. “All-Optical Spiking Neurosynaptic Networks with Self-Learning Capabilities.” Nature 569 (7755): 208–14. https://doi.org/10.1038/s41586-019-1157-8 ↗.
Fu, Tingzhao, Yubin Zang, Yuyao Huang, et al. 2023. “Photonic Machine Learning with on-Chip Diffractive Optics.” Nature Communications 14 (1): 70. https://doi.org/10.1038/s41467-022-35772-7 ↗.
Fu, Tingzhao, Jianfa Zhang, Run Sun, et al. 2024. “Optical Neural Networks: Progress and Challenges.” Light: Science & Applications 13 (1): 263. https://doi.org/10.1038/s41377-024-01590-3 ↗.
Hong, Seokjin, Berkay Neseli, Seungyeon Cho, et al. 2026. “On-Chip Photonic Neural Network Architectures.” Advanced Optical Materials 14 (39): e71567. https://doi.org/10.1002/adom.71567 ↗.
Hu, Jingtian, Deniz Mengu, Dimitrios C. Tzarouchis, Brian Edwards, Nader Engheta, and Aydogan Ozcan. 2024. “Diffractive Optical Computing in Free Space.” Nature Communications 15 (1): 1525. https://doi.org/10.1038/s41467-024-45982-w ↗.
Huang, Chaoran, Shinsuke Fujisawa, Thomas Ferreira de Lima, et al. 2021. “A Silicon Photonic-Electronic Neural Network for Fibre Nonlinearity Compensation.” Nature Electronics 4 (11): 837–44. https://doi.org/10.1038/s41928-021-00661-2 ↗.
Hughes, Tyler W., Ian A. D. Williamson, Momchil Minkov, and Shanhui Fan. 2019. “Wave Physics as an Analog Recurrent Neural Network.” Science Advances 5 (12): eaay6946. https://doi.org/10.1126/sciadv.aay6946 ↗.
Li, Jingxi, Yi-Chun Hung, Onur Kulce, Deniz Mengu, and Aydogan Ozcan. 2022. “Polarization Multiplexed Diffractive Computing: All-Optical Implementation of a Group of Linear Transformations Through a Polarization-Encoded Diffractive Network.” Light: Science & Applications 11 (1): 153. https://doi.org/10.1038/s41377-022-00849-x ↗.
Lin, Xing, Yair Rivenson, Nezih T. Yardimci, et al. 2018. “All-Optical Machine Learning Using Diffractive Deep Neural Networks.” Science 361 (6406): 1004–8. https://doi.org/10.1126/science.aat8084 ↗.
Luo, Yi, Deniz Mengu, Nezih T. Yardimci, et al. 2019. “Design of Task-Specific Optical Systems Using Broadband Diffractive Neural Networks.” Light: Science & Applications 8 (1): 112. https://doi.org/10.1038/s41377-019-0223-1 ↗.
McNeil, Alexander Montes, Yuxiao Li, Allen Zhang, Michael Moebius, and Yongmin Liu. 2024. “Fundamentals and Recent Developments of Free-Space Optical Neural Networks.” Journal of Applied Physics 136 (3): 030701. https://doi.org/10.1063/5.0215752 ↗.
Pai, Sunil, Zhanghao Sun, Tyler W. Hughes, et al. 2023. “Experimentally Realized in Situ Backpropagation for Deep Learning in Photonic Neural Networks.” Science 380 (6643): 398–404. https://doi.org/10.1126/science.ade8450 ↗.
Park, Yujin, Yewon Han, Seokwoo Kim, Joohoon Kim, and Junsuk Rho. 2026. “Free-Space and on-Chip Diffractive Deep Neural Network for Next-Generation Optical Computing.” Npj Nanophotonics, ahead of print. https://doi.org/10.1038/s44310-026-00146-0 ↗.
Quan, Zhiqiang, Bing Han, Xiaoxiao Ma, et al. 2026. “On-Chip Non-Volatile All-Optical Residual Neural Network Accelerator.” Light: Science & Applications 15 (1): 348. https://doi.org/10.1038/s41377-026-02325-2 ↗.
Rahman, Md Sadman Sakib, Xilin Yang, Jingxi Li, Bijie Bai, and Aydogan Ozcan. 2023. “Universal Linear Intensity Transformations Using Spatially Incoherent Diffractive Processors.” Light: Science & Applications 12 (1): 195. https://doi.org/10.1038/s41377-023-01234-y ↗.
Shastri, Bhavin J., Alexander N. Tait, T. Ferreira de Lima, et al. 2021. “Photonics for Artificial Intelligence and Neuromorphic Computing.” Nature Photonics 15 (2): 102–14. https://doi.org/10.1038/s41566-020-00754-y ↗.
Shen, Yichen, Nicholas C. Harris, Scott Skirlo, et al. 2017. “Deep Learning with Coherent Nanophotonic Circuits.” Nature Photonics 11 (7): 441–46. https://doi.org/10.1038/nphoton.2017.93 ↗.
Tait, Alexander N., Thomas Ferreira de Lima, Ellen Zhou, et al. 2017. “Neuromorphic Photonic Networks Using Silicon Photonic Weight Banks.” Scientific Reports 7 (1): 7430. https://doi.org/10.1038/s41598-017-07754-z ↗.
Vandoorne, Kristof, Pauline Mechet, Thomas Van Vaerenbergh, et al. 2014. “Experimental Demonstration of Reservoir Computing on a Silicon Photonics Chip.” Nature Communications 5 (1): 3541. https://doi.org/10.1038/ncomms4541 ↗.
Wang, Yufei, Mingheng Zhong, Kun Liao, Quan Sun, Xiaoyong Hu, and Qihuang Gong. 2026. “Diffractive Optical Neural Networks: Pathways Toward Intelligent and Scalable Photonic Computing.” Nanophotonics 15 (8): e70098. https://doi.org/10.1002/nap2.70098 ↗.
Xu, Xingyuan, Mengxi Tan, Bill Corcoran, et al. 2021. “11 TOPS Photonic Convolutional Accelerator for Optical Neural Networks.” Nature 589 (7840): 44–51. https://doi.org/10.1038/s41586-020-03063-0 ↗.
Xue, Zhiwei, Tiankuang Zhou, Zhihao Xu, Shaoliang Yu, Qionghai Dai, and Lu Fang. 2024. “Fully Forward Mode Training for Optical Neural Networks.” Nature 632 (8024): 280–86. https://doi.org/10.1038/s41586-024-07687-4 ↗.
Yildirim, Mustafa, Niyazi Ulas Dinc, Ilker Oguz, Demetri Psaltis, and Christophe Moser. 2024. “Nonlinear Processing with Linear Optics.” Nature Photonics 18 (10): 1076–82. https://doi.org/10.1038/s41566-024-01494-z ↗.
Zhang, Haoran, Yuhang Song, Shifan Chen, et al. 2025. “Integrated Platforms and Techniques for Photonic Neural Networks.” Npj Nanophotonics 2 (1): 40. https://doi.org/10.1038/s44310-025-00088-z ↗.
Zhang, Hui, Yiming Ma, Zhanshan Wang, Xinbin Cheng, Anthony Laing, and Ai Qun Liu. 2026. “Scaling Strategies for Photonic Neural Networks.” Nature Reviews Physics 8: 731–50. https://doi.org/10.1038/s42254-026-00984-z ↗.
Zhou, Hailong, Jianji Dong, Junwei Cheng, et al. 2022. “Photonic Matrix Multiplication Lights up Photonic Accelerator and Beyond.” Light: Science & Applications 11 (1): 30. https://doi.org/10.1038/s41377-022-00717-8 ↗.
Zhou, Tiankuang, Xing Lin, Jiamin Wu, et al. 2021. “Large-Scale Neuromorphic Optoelectronic Computing with a Reconfigurable Diffractive Processing Unit.” Nature Photonics 15 (5): 367–73. https://doi.org/10.1038/s41566-021-00796-w ↗.
Zhu, H. H., J. Zou, H. Zhang, et al. 2022. “Space-Efficient Optical Computing with an Integrated Chip Diffractive Neural Network.” Nature Communications 13 (1): 1044. https://doi.org/10.1038/s41467-022-28702-0 ↗.